

Me hace mucha ilusión saludarte en esta edición de la newsletter NDS, espero que cumpla tus expectativas y si es así, o si no lo es, estaré encantado de que me des feedback.
¿Quién es Javier Flores y qué es NDS? :)
👨💻 ¡Hola ! Soy Javier Flores, consultor SEO en VisibilidadOn y creador de Notas de SEO (NDS), que estás leyendo ahora mismo. Esta newsletter nació en noviembre de 2024 como un espacio para compartir mis aprendizajes en SEO, marketing y negocios digitales. Si te gusta, dime qué opinas. Y si no... ¡también! 😉
🗂️ En el correo de hoy
1️⃣ La viñeta
2️⃣ Actualidad SEO
3️⃣ Qué le está pasando a tu ficha de Google en noviembre
4️⃣ Cómo competir en Amazon sin ser el más barato
5️⃣ Recursos / herramientas
6️⃣ Destripando Google
7️⃣ Historia SEO

🚀 De medir tu visibilidad en IA a encontrar dónde mejorarla
Prensalink ha creado Radar, una herramienta para medir cómo aparece tu marca en ChatGPT, Gemini, Claude y Google AI y compararla con tus competidores.
Pero lo más interesante es que Radar analiza las fuentes que utilizan o citan estos sistemas y las cruza con el catálogo de medios de Prensalink.
Así no solo ves dónde no apareces: también detectas oportunidades concretas para publicar en medios relevantes para tus consultas.
Puedes probar Radar gratis con 1 proyecto, hasta 10 prompts y análisis semanal.
👉 Descubre tus oportunidades de visibilidad en IA con Radar
🖌️ La viñeta
📸 Actualidad SEO
Noticias que lees en un ratillo.
[🧾 Google documenta por fin qué referrer manda la Búsqueda] Página nueva en Search Central desde el 12 de noviembre. Google usa la política origin, así que en el Referer solo va - https://www.google.com/ - (o el dominio local) y nunca la consulta. Discover e Imágenes mandan el mismo valor, o sea que un google.com en tus logs no te dice de qué superficie viene la visita, y de AI Mode y AI Overviews no dice nada. Tampoco menciona el redirector google.com/goto, que según DataForSEO se usa desde finales de agosto (El SEOmanal).
Por cierto, Brave ya cifra los enlaces de sus resultados y culpa al goto: dice que los scrapers que no pudieron con Google se le echaron encima. Leer SERPs cada vez sale más caro (acuérdate de las SERPs envenenadas de la NDS #95).
[🛍️ En ChatGPT casi nadie va de compras] Rand Fishkin ha analizado 118.163 prompts de 12.321 usuarios de EE. UU. (panel de Verso, de enero a octubre de 2026) y solo el 6,9% tiene que ver con investigar una marca para comprar. En Google, con la misma definición, pasaba del 15%. Lo que más se hace en ChatGPT es generar imágenes (16,1%) y buscar información y ocio (14%), y la categoría de compras, marcas y servicios locales se queda en el 5,7%. Su resumen: “It’s not a search engine”. Para Rand la visibilidad en IA sí importa, pero por AI Overviews y AI Mode, no por ChatGPT. Cuadra con el 0,62% de tráfico de la NDS #96.
[🎓 Nace Curso IA Barcelona, para los que siguen en el “no me fío”] “Lo probé y me inventó datos” es la frase que más oye David Carrasco cuando habla de IA con alguien que no la usa a diario. Y tiene razón, se inventa cosas. El problema viene después, cuando se cierra la pestaña y no se vuelve a abrir, mientras el de la mesa de al lado, con el mismo puesto y los mismos años, lleva meses preparando reuniones y borradores con ella. Por eso ha montado este curso, clases presenciales con tus tareas de verdad, hasta que sepas cuándo fiarte de la IA y cuándo no. Su meta, “si dentro de un año no me necesitas, habré hecho bien mi trabajo”. Acaba de estrenar la página y ahí irá contando las clases, las dudas que da vergüenza preguntar y los errores, los suyos incluidos.
[🕵️ Así ordena ChatGPT lo que va a citar (según un leak)] Metehan Yeşilyurt (Peec AI) encontró en septiembre un payload de depuración escondido en las respuestas de ChatGPT con búsqueda, y OpenAI lo cerró un mes después. En su charla de TechSEO Connect cuenta lo que vio: 10 motores “Labrador” en cada consulta (web, Reddit, PDF, Wikipedia, YouTube, noticias...) y una puntuación que es una suma simple, donde estar dentro de la ventana de fechas da 100 puntos de golpe y cada frase entre comillas que coincida, otros 100. Reddit se recuperó 24 veces y no entró ni una en el prompt. Y el modelo lee unas 200 palabras de cada página. Sus consejos van por ahí: fecha visible, lo importante arriba y una URL por página. Es ingeniería inversa suya, no un documento de OpenAI.
[🫥 Google prueba a esconder AI Mode] Glenn Gabe cazó una SERP sin pestaña de AI Mode y AI Overviews sin la caja “Ask anything”, diez días después de que quitaran los botones de AI Mode de la home. Barry Schwartz no lo consigue replicar. Chris Long cree que AI Mode deja de ser una experiencia aparte, y otros lo ven por la pasta: los anuncios de AI Mode rinden menos (lo contamos en la NDS #97). El 19 de noviembre Barry añadió casos de búsquedas en móvil sin AI Overview. ¿Test o ruido? De momento nadie lo sabe.
[🧠 Pichai ve la Búsqueda dentro de una capa de agentes] En una entrevista con Alex Heath, Sundar Pichai dice que la visión a corto plazo es “one box” y que espera que sus agentes unifiquen Search, AI Overviews y Gemini. Las consultas agénticas en Gemini, según él, no paran de crecer. Lo cuenta Roger Montti en SEJ, que se pregunta lo que nos preguntamos todos: si en esa capa queda sitio para mandar visitas a webs.
[⚡ Gemini 4 Hydrogen llega a la Búsqueda en plena core] Robby Stein lo anunció el 12 de noviembre como “the biggest model upgrade to Search yet”, ya disponible para todo el mundo. Promete entender mejor las preguntas de varias partes, mejor fan-out, “a broader range of helpful links”, más tablas y respuestas visuales. Ni una cifra de tráfico. Según El SEOmanal, es el modelo por defecto de AI Mode desde ese día, aunque la ayuda en español seguía hablando de Argon el 15. Si estás midiendo la core, apúntalo: son dos cambios a la vez (el protocolo lo tienes en la NDS #98).
👨🎓 Qué le está pasando a tu ficha de Google en noviembre
1. Ask Maps llega a España. El 16 de noviembre Google anunció que Ask Maps, la búsqueda conversacional de Maps, empieza a llegar a 30 países de Europa, “including Spain, Germany, and the U.K.”. No hay fecha por país. Google lo llama “the biggest update to Google Maps in over a decade” y presume de información de más de 300 millones de lugares y reseñas de más de 500 millones de personas (post para Europa). Las preguntas de ejemplo son de este estilo: “find me a public tennis court with lights for playing tonight”. Ojo a lo que viene de EE. UU.: Ask Maps ya busca citas de belleza, mascotas, taller y reparaciones del hogar, y llama a los negocios por ti para ver huecos (“Find me a 4 p.m. nail appointment near me”). Esa parte sale primero allí y Google no explica cómo elige a qué negocios llamar (SEJ).
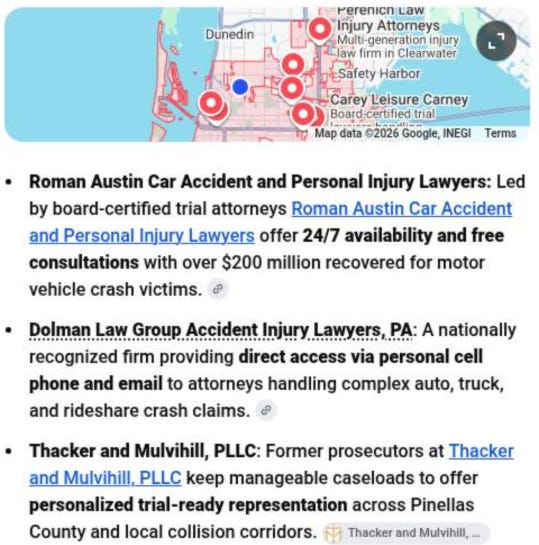
2. Un pack local dentro de los AI Overviews, sin nada de nada. Joy Hawkins lo vio el 4 de noviembre en móvil en EE. UU. (abogados en Clearwater, reparación de puertas de garaje en Phoenix): una lista con el nombre en negrita y una descripción generada. Sin estrellas, sin fotos, sin horario, sin dirección y sin botones de llamar, cómo llegar o web. Y cuando sale, el pack local de siempre desaparece. Lo curioso es que los anuncios locales de arriba sí conservan estrellas, horario y dirección. Google no lo ha anunciado y no hay pruebas en España (El SEOmanal).
3. Botones de reserva que aparecen solos. También Hawkins avisó el 6 de noviembre de fichas de negocios de servicios con botón de reserva sin tener ningún sistema conectado, y algunos llevaban a una página de Google con error 500. A Barry Schwartz se lo añadieron sin pedirlo, y Syed Amir vio que poner la página de contacto como enlace de reserva activa el botón. La ayuda de Google dice que los enlaces pueden venir de proveedores externos y que, para quitar uno, se lo tienes que pedir al proveedor, que tiene cinco días hábiles (El SEOmanal).
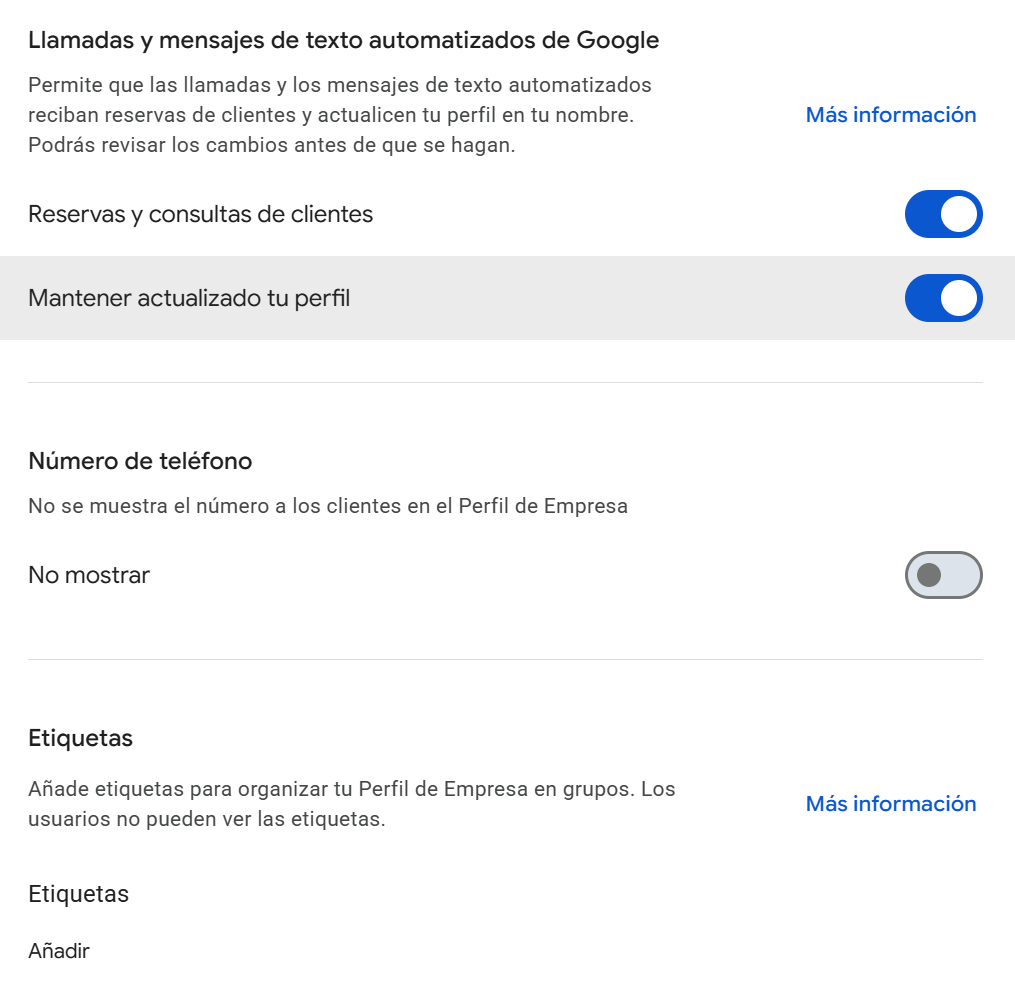
4. El interruptor para que Google no llame por ti. En el Perfil de Empresa, Más > Configuración del Perfil de Empresa > Configuración avanzada, sección “Google automated calls and text messages”, está el ajuste “Bookings and inquiries from customers”. De momento solo aplica en EE. UU. y SEJ recuerda que nadie sabe si las llamadas de Ask Maps lo respetan. Si tienes clientes con ficha en EE. UU., míralo ya. En España, apúntatelo para cuando llegue.
Checklist para revisar la ficha esta semana
Categoría principal y secundarias bien elegidas. Es lo primero que usa Google para saber si encajas en una pregunta.
Servicios y atributos completos. Si alguien le pregunta a Ask Maps por “pista con luz para jugar esta noche”, la respuesta tiene que salir de algún sitio, y lo que no esté en la ficha difícilmente lo va a encontrar.
Reseñas con detalle. Pide a los clientes que cuenten qué compraron o qué servicio usaron, no solo las estrellas.
Enlace de reserva: entra en la ficha y comprueba si hay un botón que no pusiste tú. Si viene de un proveedor, pídele que lo quite; y no uses la página de contacto como enlace de reserva.
Horario especial de Black Friday y puente de diciembre.
Busca tu negocio desde google.es en móvil y mira qué sale. Si ves el pack sin botones, haz captura con fecha y avísame, que de momento no hay ningún caso documentado en España.
📺 Entrevista a David Juan Manuel | Cómo competir en Amazon sin ser el más barato | Tablakala
🧰Herramientas / recursos
Wayback Machine Capture Comparison
[🕰️ Compara dos versiones de cualquier URL con Wayback Machine] Search Console o SISTRIX te dicen cuándo cayó una página, pero no qué cambió en ella.
MJ Cachón explica cómo sacarlo con dos herramientas de Internet Archive. Con Changes eliges dos días en un calendario (cuanto más oscuro, más cambios ese día) y ves el texto quitado y añadido resaltado; además es la única que guarda el historial del robots.txt, muy útil para espiar a la competencia.
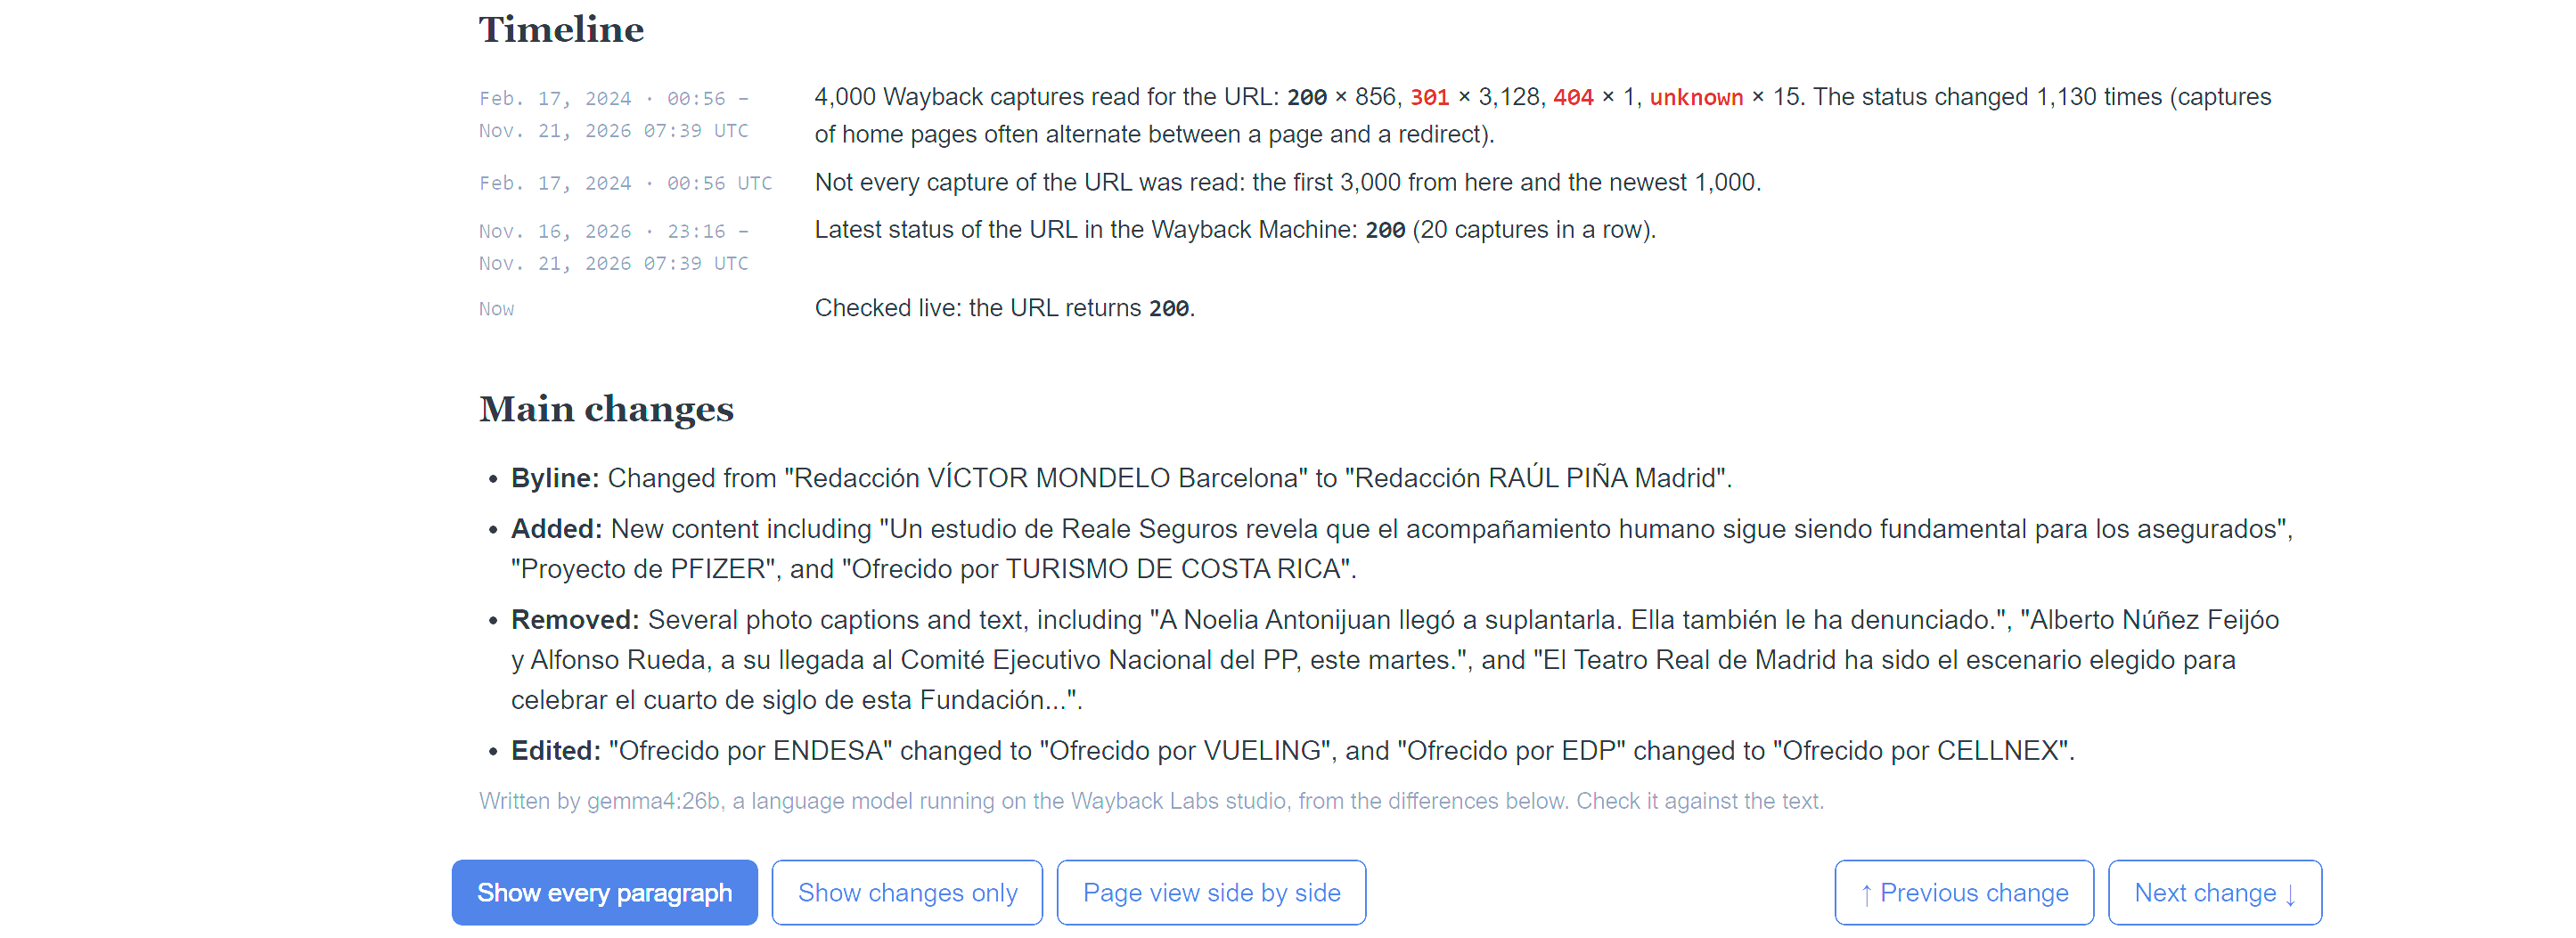
La otra, Capture Comparison, está en Wayback Labs, te deja elegir capturas de un desplegable y te hace un resumen con IA (que hay que revisar). El truco que más me ha gustado, añadir id_ después de la fecha en la URL de la captura te da el HTML original, sin el marco de Wayback, para comparar title, canonical, meta robots o datos estructurados. Ojo, las capturas no son lo que vio Googlebot. Y si vas a hacer una migración, guarda antes las URLs clave con Save Page Now.
🔍Google Merchant Center, la base de datos que alimenta Shopping, Performance Max y ahora la IA
Si tienes una tienda, Merchant Center es el sitio donde le cuentas a Google qué vendes, a qué precio y si lo tienes en stock. De ahí salen los listados gratuitos de Shopping, los anuncios de Shopping, la parte de producto de Performance Max y, cada vez más, lo que AI Mode y los agentes de compra saben de tus productos. Mucha gente lo deja en manos del equipo de PPC, pero un feed mal hecho también te cuesta tráfico gratis.

Un poco de historia para entender cómo hemos llegado aquí.
Hasta 2020, salir en Google Shopping era pagando. El 21 de abril de 2020 Bill Ready anunció que la pestaña de Shopping pasaría a tener “primarily free listings” en EE. UU., con la idea de llevarlo al resto del mundo antes de acabar el año. En junio lo extendieron a la página de resultados normal.
Entre julio y septiembre de 2022 Google pasó automáticamente todas las campañas de Smart Shopping a Performance Max, prometiendo de media un 12% más de valor de conversión con el mismo ROAS (Search Engine Land).
En mayo de 2023 presentó Merchant Center Next, una versión simplificada (SE Roundtable). En septiembre de 2024 ya estaban todos migrados, los “feeds” pasaron a llamarse fuentes de datos y los diagnósticos se fueron a la pestaña “Necesitan atención” (ayuda de Google). En julio de 2026 le quitaron el “Next” y vuelve a llamarse Merchant Center a secas.
La Content API for Shopping, la que usaban muchos plugins y conectores, se apagó el 18 de agosto de 2026. Desde el 1 de septiembre las peticiones fallan a ratos con un 410 y a principios de 2027 se desconecta del todo. Su sustituta es la Merchant API. Si tu tienda sube productos con un desarrollo propio o un plugin viejo, revisa hoy mismo que ya use la API nueva. Si usas Shopify o una plataforma similar, la migración la hace la plataforma.
Cómo entran tus productos.
Puedes subirlos con un archivo, una hoja de Google Sheets, la API o una app de tu plataforma (en Shopify, la de Google & YouTube). Y luego está la parte que más debería importarle a un SEO: las actualizaciones automáticas. Según la ayuda de Merchant Center, Google puede corregir el precio, el precio de oferta, la disponibilidad y el estado del producto (nuevo, usado, reacondicionado) leyendo los datos estructurados de tu web. Vienen activadas por defecto. El ejemplo de Google: si el feed dice 4 $ y la página dice 3 $, el producto pasa a 3 $.
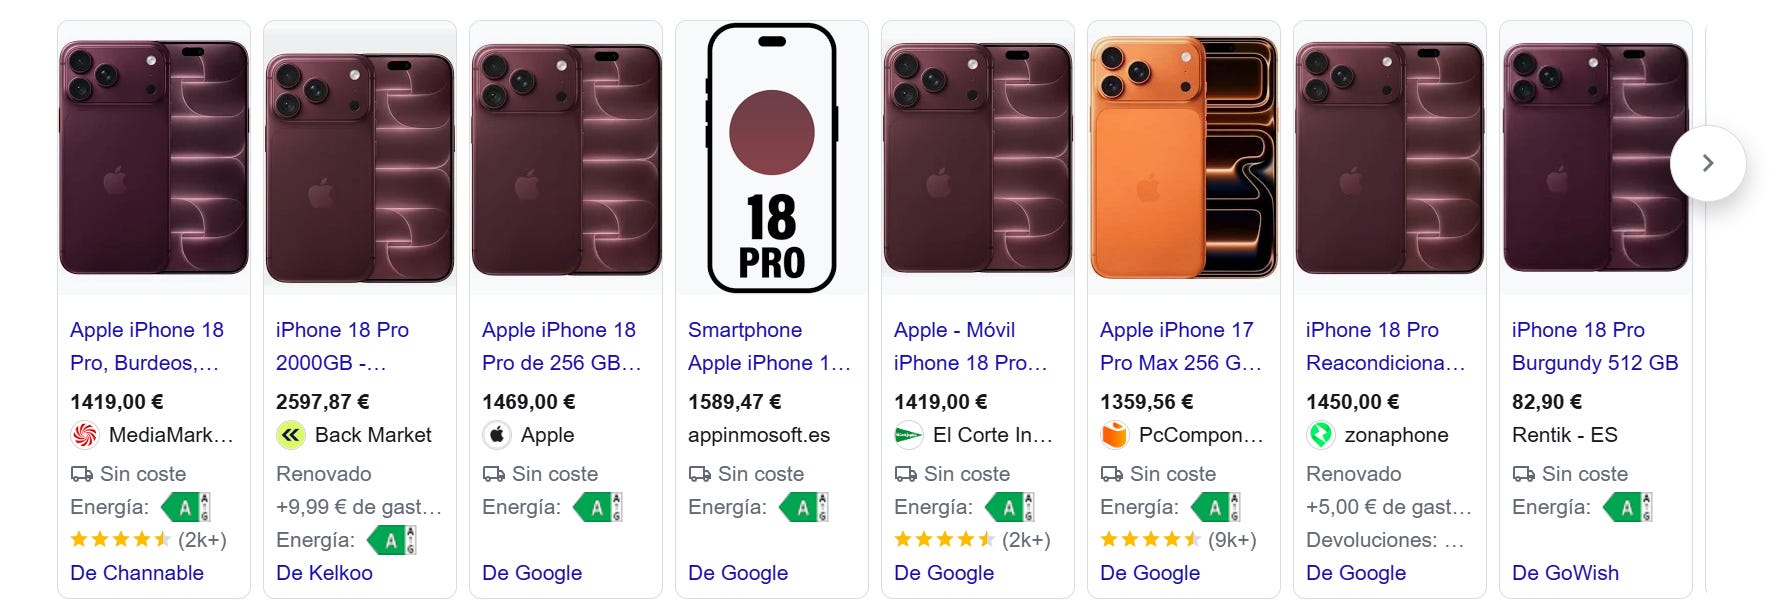
Tiene trampa:
Google avisa de que no sustituye a actualizar el feed y de que puede fallar si cambias precios o stock más de una vez al día. En Black Friday, justo.
Si la ficha muestra un precio tachado y el precio rebajado, puede quedarse con el que no es. Google recomienda no activar la automatización de precio en ese caso.
Si no encuentra el marcado, tira de “advanced data extractors”, y si tampoco así saca precio, disponibilidad o estado, el producto se rechaza.
O sea, el schema de Product que tienes en la ficha no es solo para los resultados enriquecidos. Si no cuadra con el feed, Google corrige el feed con lo que lee en tu web, para bien o para mal.
Los atributos que de verdad importan.
La especificación de datos de producto pide como mínimo id, title, description, link, image_link, price y availability, y brand para productos nuevos. El título admite hasta 150 caracteres y la descripción hasta 5.000.
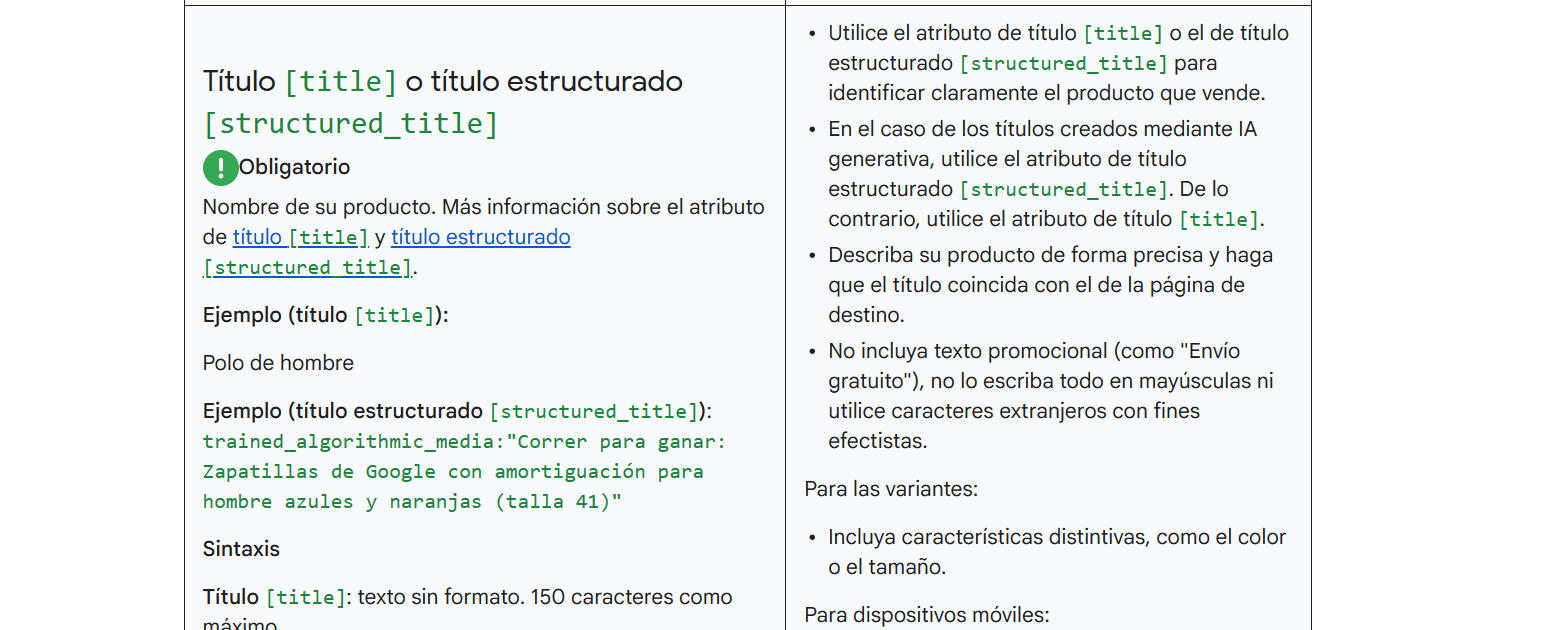
El título es tu keyword de toda la vida. Lo que no está en el título del feed difícilmente va a hacer que salgas en una búsqueda de Shopping, así que “Zapatilla Running Hombre Modelo X Talla 42 Negra” funciona mejor que “Modelo X”. Las imágenes tendrán que medir como mínimo 500 x 500 desde el 31 de enero de 2027 y sin textos promocionales, marcas de agua ni bordes (te lo conté en la NDS #96 y en la NDS #98). Y los custom_label_0 a custom_label_4 no los ve el usuario, pero son lo que usa quien gestiona Performance Max para separar productos por margen, temporada o “más vendidos”. Si tu equipo de PPC te los pide, no es capricho.
Dónde acaba todo esto.
Listados gratuitos: la pestaña de Shopping, bloques de producto en la Búsqueda, Imágenes... En la UE tienes que elegir un CSS o te pueden rechazar los productos (el paso a paso, en la NDS #98).
Anuncios de Shopping: con una campaña de Shopping estándar o dentro de Performance Max.
Performance Max: sale en Búsqueda, Maps, YouTube, Discover, Gmail y la Red de Display. Con tu feed, según la ayuda de Google Ads, hace anuncios de Shopping en la Búsqueda de Google, la búsqueda de YouTube, Maps y partners de búsqueda, y remarketing dinámico en Display. Durante años fue una caja negra, hasta que en abril de 2025 Google anunció el informe por canal.
Un detalle que mucha gente no sabe: hasta octubre de 2024, si tenías Performance Max y Shopping estándar con los mismos productos, PMax ganaba siempre. Desde entonces gana el que tenga mejor Ad Rank, como en cualquier otra campaña.
Y lo que viene, el Shopping Graph
Todo lo que mandas a Merchant Center va al Shopping Graph, la base de datos de productos de Google. En febrero de 2023 Google hablaba de más de 35.000 millones de fichas. En noviembre de 2025, de más de 50.000 millones, con 2.000 millones actualizándose cada hora, y en mayo de 2026 ya superaba los 60.000 millones (PPC Land). De ahí sacan los datos AI Mode cuando te recomienda productos y el carrito universal y el checkout con agentes que vimos en la NDS #96.
Antes Merchant Center era lo de los anuncios. Ahora, si un agente va a comprar por tu cliente, lo que lea de tu tienda va a salir de aquí y de los datos estructurados de tu web, no de tu home ni de tu blog.
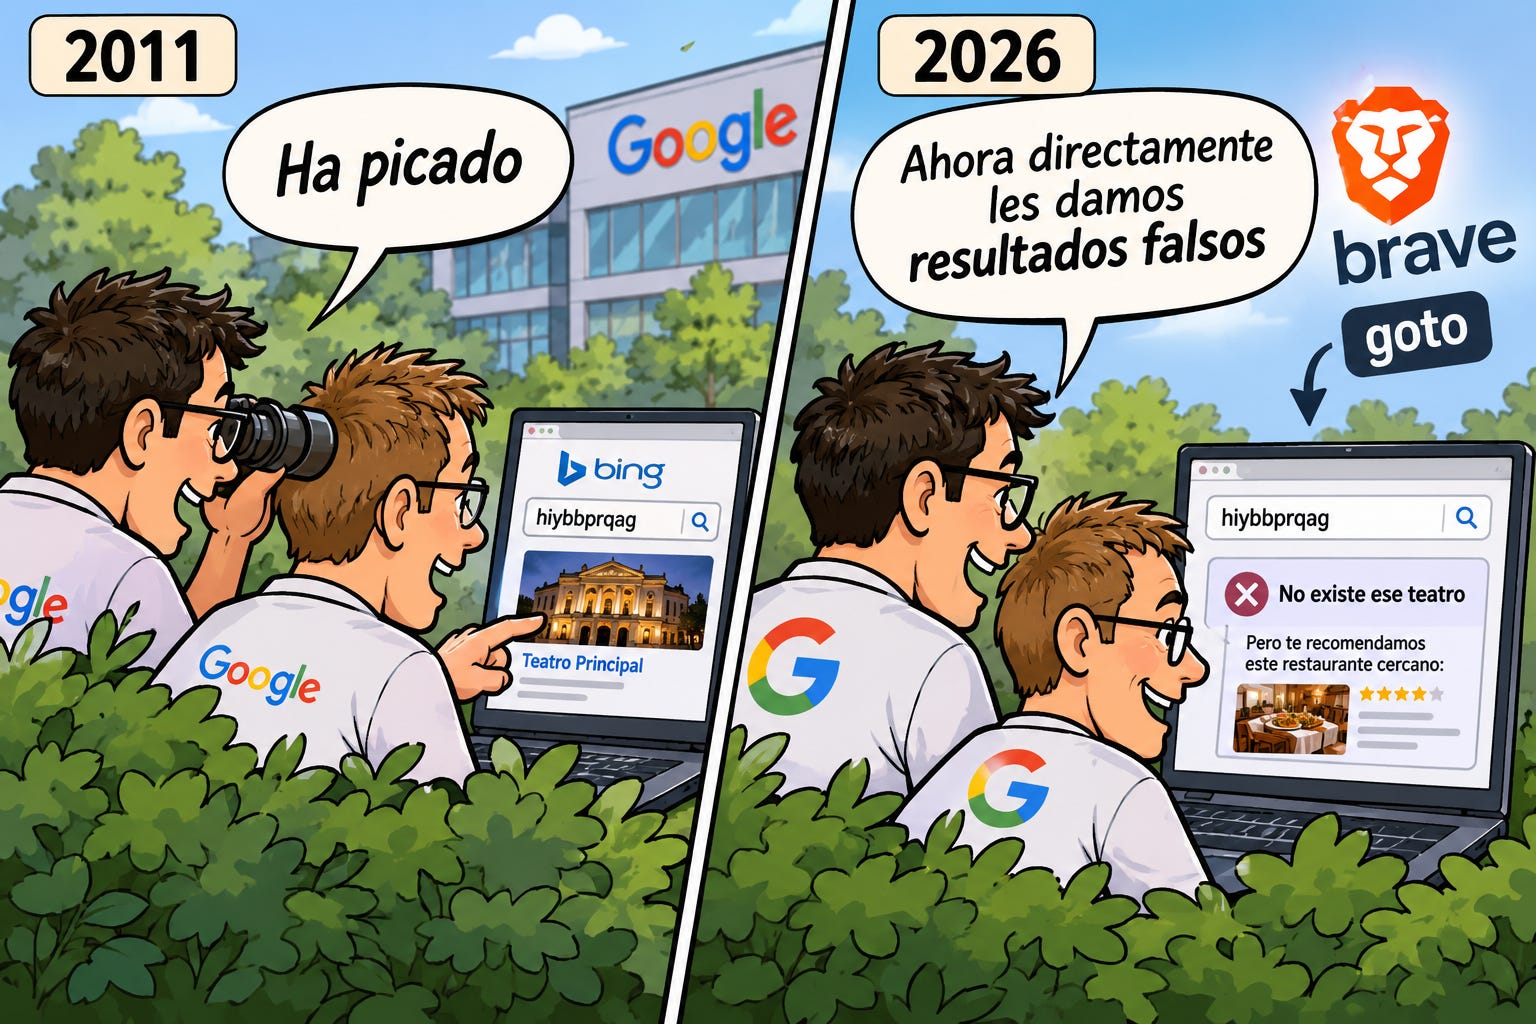
🏛️hiybbprqag, la trampa con la que Google pilló a Bing copiando (2011)
Si en enero de 2011 buscabas “hiybbprqag” en Bing, te salía la página de los asientos del Wiltern, un teatro de Los Ángeles. No tiene ningún sentido, porque esa palabra no existe. La había inventado Google, y el resultado también lo había puesto Google a mano. Era un cebo.
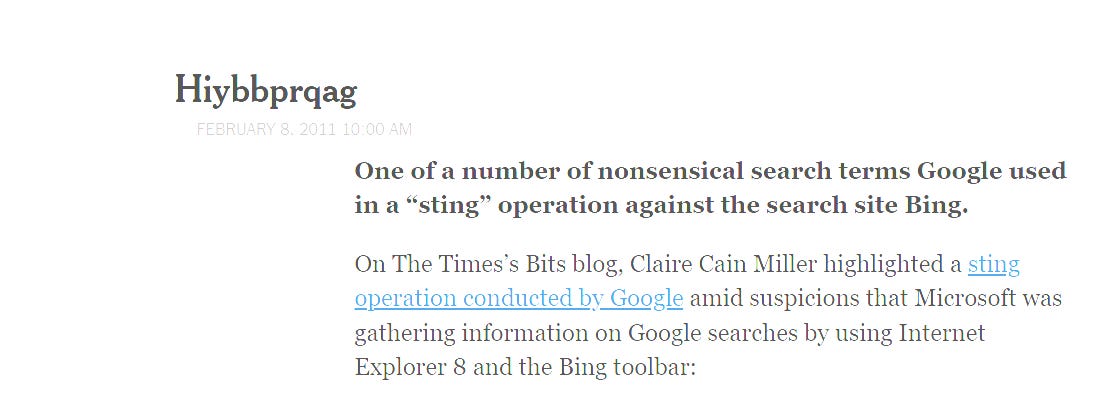
La sospecha venía de lejos. En mayo de 2010 Google se dio cuenta de que Bing devolvía para la errata “torsoraphy” el mismo resultado que Google, que la corregía por tarsorrhaphy (una operación de párpados), sin que Bing mostrara la corrección. En octubre vieron que cada vez coincidían más sus top 10 y sus números uno. Así que en diciembre montaron un experimento (Danny Sullivan en Search Engine Land lo cuenta con todo detalle):
Crearon unas 100 búsquedas que nadie haría nunca, como “hiybbprqag”, “mbzrxpgjys” o “juegosdeben1ogrande”.
Para cada una colocaron a mano un resultado que no tenía nada que ver: una cooperativa de crédito, una web de joyas de hip hop, el plano de un teatro.
20 ingenieros, desde casa y con un Windows recién instalado, Internet Explorer 8 y la Barra de Bing, las buscaron en Google y pincharon en esos resultados. Empezaron el 17 de diciembre.
Un par de semanas después, los resultados falsos empezaron a salir en Bing. Según Sullivan, entre 7 y 9 de las 100 búsquedas, dependiendo del día en que lo miraran. Pocas, pero suficientes, porque esas páginas solo estaban relacionadas con esas palabras en un sitio del mundo: Google.
El 1 de febrero de 2011, justo antes de un evento sobre búsqueda en el que estaban los dos, Amit Singhal publicó en el blog oficial de Google que Bing usaba sus resultados “and denies it”. Su teoría era que Microsoft recogía lo que hacían los usuarios con la función de Sitios sugeridos de IE8 y la Barra de Bing, y así veía qué buscaban en Google y dónde pinchaban. A Sullivan le dijo que aquello era “plain and simple cheating” y que “copying is not innovation, in my book”.
Microsoft no lo negó del todo. Stefan Weitz, director de Bing, explicó que usaban “multiple signals”, entre ellos los datos de clics de la barra, y llamó al experimento “a hack to confuse and manipulate some of these signals”. Harry Shum, vicepresidente de Bing, fue más allá en el blog de Bing: dijo que tenían más de 1.000 señales en su algoritmo, que aquello había sido “a spy-novelesque stunt to generate extreme outliers in tail query ranking” y que se lo tomaban como “a back-handed compliment” (Expert Reviews).
Quince años después, la pelea va de lo mismo, solo que ahora el que copia es un scraper que le vende las SERPs a un chatbot. Google mete sus clics por google.com/goto desde agosto y envenena las SERPs que ven los rank trackers (te lo conté en la NDS #95). Y esta semana Brave ha empezado a cifrar los enlaces de sus resultados porque, según ellos, los scrapers que no pudieron con Google se le echaron encima. En 2011 Google puso un cebo para demostrar que le copiaban. Ahora directamente le da datos falsos a quien no debe verlos.
Estamos en contacto
Puedes encontrarme en Linkedin, Twitter, mi blog, en mi canal de Youtube o trabajando a diario en la Agencia VisibilidadOn
🤜🤛 Si quieres que escriba sobre un tema concreto, que analice alguna web en vivo, que pruebe alguna herramienta, patrocinar la newsletter o financiarme un viaje en moto por Europa ahora es el momento, ¡contáctame!
📚 Si te has perdido alguna publicación o quieres revisar las anteriores, tienes el archivo disponible online para tí.