NDS #94 - Lo que Google contó en Barcelona, el mayor robo de la historia según Microsoft, los rincones ocultos de Search Console, curso Shopify B2B... ¡y más!
Analizamos las novedades semanales del sector SEO e IA y sobre todo cómo nos puede afectar como consultores y te cuento mis vivencias y aprendizajes sentado varias horas al día frente a un monitor.
Me hace mucha ilusión saludarte en esta edición de la newsletter NDS, espero que cumpla tus expectativas y si es así, o si no lo es, estaré encantado de que me des feedback.
¡Únete! ¡Somos más de 500 suscriptores en #NDS! 📬
¿Quién es Javier Flores y qué es NDS? :)
👨💻 ¡Hola ! Soy Javier Flores, consultor SEO en VisibilidadOn y creador de Notas de SEO (NDS), que estás leyendo ahora mismo. Esta newsletter nació en noviembre de 2024 como un espacio para compartir mis aprendizajes en SEO, marketing y negocios digitales. Si te gusta, dime qué opinas. Y si no... ¡también! 😉
🗂️ En el correo de hoy 1️⃣ La viñeta 2️⃣ Actualidad SEO 3️⃣ Problemas con canonical en <head> 4️⃣ Cómo bloquear IPs en htaccess 5️⃣ Destripando Google 6️⃣Historia SEO
El año pasado lanzamos una formación por email para preparar el Black Friday y os encantó. Este año Josep Deulofeu ha ido un paso más allá, ha grabado un curso de 8 lecciones con recursos prácticos y skills de IA, para que no te quedes en la teoría y lo puedas aplicar.
Y no lo ha preparado solo, se ha rodeado de gente que sabe mucho de eCommerce.
Josep Deulofeu se encarga de cuatro lecciones, la puesta a punto de la tienda, el antes, durante y después de un Black Friday rentable, el SEO/GEO y el calendario de comunicación.
La idea es que termines con un plan claro para SEO, Ads, email y UX, en lugar de improvisar la semana antes. Si tienes una tienda online, o clientes que la tienen, este es el momento: el Q4 se prepara ahora.
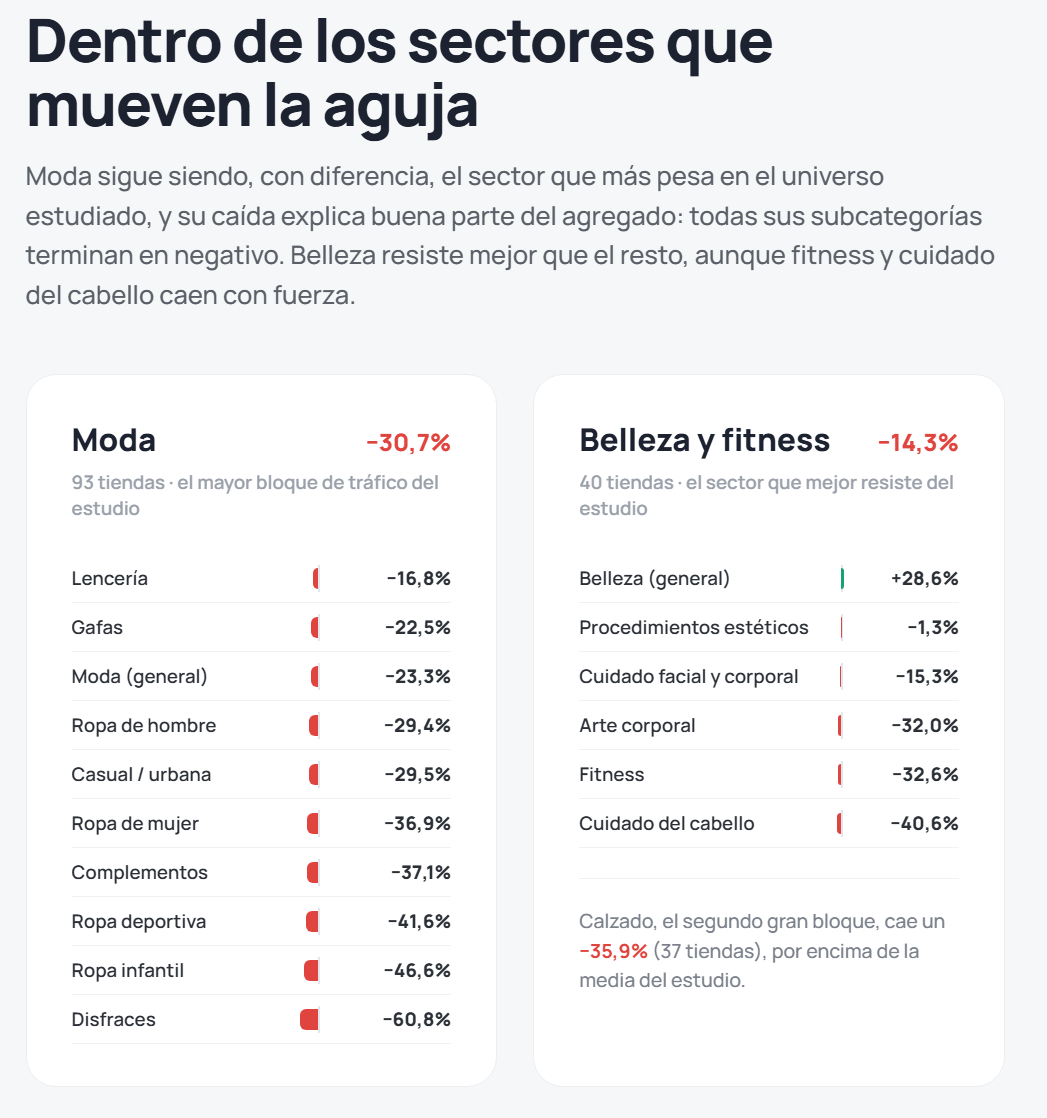
[🛍️ Septiembre se carga la recuperación en Shopify Plus] Nuestro estudio mensual sobre 998 tiendas Shopify Plus en España da un −31,9% interanual, con todos los sectores en rojo y solo 43 tiendas creciendo. Una caída tan uniforme apunta a un cambio de Google o de Ahrefs más que a la demanda, así que la tomamos con pinzas hasta el próximo corte.
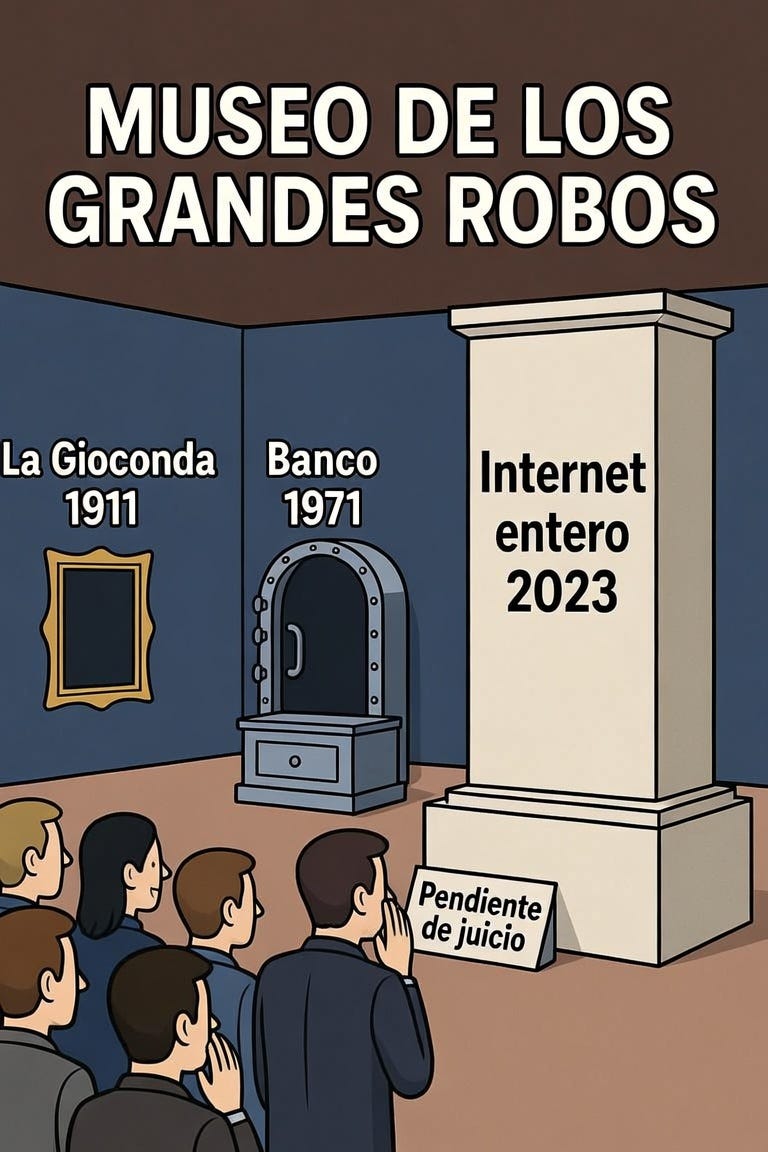
[🏴☠️ El mayor robo de trabajo de la historia, según un directivo de Microsoft] Enrique Dans repasa los documentos del juicio contra OpenAI y Microsoft, con un directivo de Microsoft llamando así al scraping para entrenar IA y correos sobre cómo saltarse el paywall de los medios. Lo sabían y lo hicieron igual, en palabras de Brent Hecht podríamos estar ante el mayor robo de trabajo de la historia de la humanidad.
[🏭 Curso de Shopify B2B en la Academia VON] Si tu tienda Shopify ya funciona en B2C, vender a mayoristas es probablemente la oportunidad que estás dejando pasar. Este mes arranca el curso de Dani Santos en la Academia VON, 6 lecciones para montar un B2B completo, con segmentos por tipo de mayorista, catálogos con precios por segmento, descuentos por volumen y pedido mínimo, y formulario de alta que gestionas desde el admin. Lo mejor es que no hace falta Shopify Plus ni saber programar, vale cualquier plan.
[⏳ Search Console se queda casi tres días sin datos] El informe de rendimiento llegó a 64 horas de retraso después del spam update, algo que no pasaba desde diciembre de 2025. Ya está resuelto, así que si el fin de semana viste tus gráficas hundidas, era falta de datos.
Parte de la cuenta de resultados para sacar el valor de cada sesión orgánica (conversión × ticket medio × margen, con calculadora incluida) y monta una tabla por page type que suele contradecir lo que cree el equipo, el blog con más clics es el que menos dinero deja.
Me gusta mucho cómo separa “Descubierta” de “Rastreada: actualmente sin indexar”, que parecen el mismo problema y piden soluciones opuestas (rastreo vs calidad). De ahí a OKRs con KR en número absoluto, nunca en porcentaje, y sprints semanales con Kanban. Muy en la línea de lo que contamos en la NDS #68, el SEO tiene que ser rentable.
[🤿 Discover prueba Dive deeper con resúmenes de IA] Google está probando un botón en Discover que, en lugar de llevarte al artículo del medio, te abre un resumen del tema generado con IA con enlaces a noticias relacionadas, reacciones de la comunidad y la información original. Lo anunció Robby Stein (Google) en X, de momento solo en vídeos y con varios diseños en pruebas.
Barry Schwartz lo resume bien, si el usuario ya tiene todo el contexto en el resumen, ¿para qué va a hacer clic? Después de los AI Overviews en las SERPs, ahora le toca al tráfico de propina de los medios.
Plantaron enlaces trampa en chats privados y acabaron abiertos desde IPs de terceros. El título que genera la IA para tu conversación viaja a Meta, TikTok o DoubleClick con identificadores persistentes (en el estudio, Salario 85k NYC: hipoteca 280-350k). Rechazar cookies deja activos el 80,8% de los rastreadores, pagar apenas cambia nada y parte del envío va de servidor a servidor, donde ningún adblocker llega.
En su análisis, los dominios externos suponen entre el 69,6% y el 82,3% de las fuentes más citadas. Así que ha montado dos frameworks con plantilla en Google Sheets, uno para priorizar contenido propio (fuera definiciones genéricas, FAQs troceadas y programáticas con datos públicos) y otro para elegir dónde conseguir citas de terceros, con un aviso para los que ahora quieren estar en Reddit “porque lo cita ChatGPT”, si mañana cambian las fuentes, ese trabajo se queda en nada.
[🍊 Quality en Google, lo que se contó en Barcelona] Nacho Mascort resume la charla de quality del Search Central Live de Barcelona en este increíble post que esta semana he estado desgranando punto a punto. Apúntate el test de commodity, si cambias tu marca por la de un competidor y la página vale igual, es commodity. Y el dato de Gary Illyes, salir de un core update lleva 3-6 meses de media, y con mala calidad Google puede tardar meses en indexarte o no hacerlo nunca.
[⚖️ USA Today demanda a OpenAI] El grupo y varios de sus periódicos acusan a OpenAI de entrenar ChatGPT con cientos de miles de artículos sin permiso y piden más de 250 millones de dólares. Se suma a la lista de demandas de medios y autores (New York Times incluido) contra OpenAI, Anthropic o Meta, que se defienden con el fair use.
Me quedo con varias. Estar indexado no significa que la IA te vaya a elegir como fuente, no existe un “Discoverbot” (Discover tira de Googlebot y del índice de Search), y JSON-LD es cómodo de mantener pero no da ventaja algorítmica frente a Microdata o RDFa.
Para eCommerce, ojo a los Conversational Attributes de Merchant Center, preguntas y respuestas de producto que tienes que validar con soporte y fabricante antes de subirlas. Y un detalle técnico que pocos saben, nosnippet también saca tu contenido de AI Overviews y AI Mode.
👨🎓 Problemas con canonical en <head>
Lo bueno de trabajar en una agencia con un gran equipo y muchos proyectos es que cada día se aprende algo. Esta semana nos ha tocado uno de esos errores que te hacen dudar de todo. Un proyecto en el que Search Console nos decía que Google estaba ignorando las canonicals y eligiendo por su cuenta otra URL. Abríamos el código fuente y ahí estaba la etiqueta, en el <head>, perfecta. Revisamos plantillas, redirecciones, sitemap... y nada.
El problema estaba un poco más arriba. Dentro del <head> había un <div>, metido por un script de terceros. Y aquí viene lo curioso, un <div> no puede vivir en el <head>, así que cuando el navegador (y Google) leen la página y se lo encuentran, dan el <head> por cerrado en ese punto y mandan todo lo que viene después al <body>. Incluida nuestra canonical.
Y Google lo deja claro en su documentación, las canonicals que aparecen en el <body> las ignora. Lo mismo puede pasar con el meta robots, los hreflang o cualquier etiqueta que vaya detrás del intruso.
La trampa es que en el “ver código fuente” todo parece correcto. Para verlo de verdad tienes que mirar el HTML ya procesado, en la inspección de URL de Search Console o en la pestaña Elementos de las DevTools de Chrome, donde ves la canonical colocada dentro del <body>.
¿La solución? Sacar ese elemento del <head> y, por si acaso, subir la canonical y las etiquetas importantes lo más arriba posible. Revisad vuestras webs, sobre todo si tenéis muchos píxeles, banners de cookies o apps instaladas, porque son los sospechosos habituales.
📺 Cómo bloquear IPs en htaccess y eliminar SPAM
🔍 Destripando Google, los rincones de Search Console que casi nadie mira
Este fin de semana el informe de rendimiento de Search Console estuvo más de 64 horas sin actualizarse, justo después del spam update (lo contó Barry Schwartz). Y a la vez, las herramientas de seguimiento de posiciones andan tocadas porque Google les está poniendo las cosas difíciles para scrapear. Moraleja, el único dato que viene directo de Google es el de Search Console, y la mayoría lo usamos para mirar la gráfica de clics y poco más.
Así que esta semana vamos a abrir los cajones que solemos dejar cerrados.
Rendimiento, mucho más que la gráfica de clics
Google ha metido más novedades en este informe en el último año que en los cinco anteriores. Las que más uso:
Filtro de consultas de marca (noviembre de 2025). Separa automáticamente las búsquedas de marca, con sus variantes y faltas de ortografía. Lo contamos en la NDS #68 y para mí es lo primero que hay que activar en cualquier proyecto, porque si no, cualquier subida de notoriedad parece trabajo SEO.
Anotaciones personalizadas (noviembre de 2025, NDS #54). Marca en la gráfica cuándo subiste una plantilla nueva, cuándo migraste o cuándo empezó un core update. Dentro de seis meses no te vas a acordar, y tu cliente tampoco.
Vistas semanal y mensual (diciembre de 2025). Quitan el ruido de lunes contra domingos. Y en el otro extremo, la vista de 24 horas con datos por hora, que desde abril de 2025 también puedes sacar por API.
Configuración con IA (diciembre de 2025). Le escribes algo como “CTR de las consultas con ‘cómo’ en España la semana pasada” y te monta los filtros. Funciona solo con el rendimiento de la búsqueda web, y conviene revisar qué filtros ha puesto antes de sacar conclusiones.
Grupos de consultas en Insights (octubre de 2025). Agrupa con IA las variantes de una misma búsqueda y te dice qué grupos suben y cuáles bajan. Solo sale en propiedades con mucho volumen de consultas.
Y la gorda del año, el informe de IA generativa. Google lo lanzó en junio en beta y desde agosto ya aparece en todas las propiedades, como una pestaña desplegable dentro de Rendimiento. Te enseña cuántas veces han salido tus URLs en AI Overviews, AI Mode y en las funciones de IA de Discover, por página, dispositivo y fecha. En la NDS #76 nos quejábamos de que Search Console no separaba nada de esto, así que algo hemos ganado. Ojo, por ahora la métrica son impresiones, no clics, así que úsalo para ver qué páginas usa la IA como fuente, no para medir tráfico.
Un límite que conviene recordar, la interfaz solo te enseña 1.000 filas. Si trabajas webs grandes, tira de la API o de la exportación masiva a BigQuery, que existe desde 2023 y casi nadie tiene configurada.
Core Web Vitals, el informe que más se malinterpreta
Lo primero, estos datos no salen de Lighthouse ni de PageSpeed en modo laboratorio. Son datos de campo de CrUX, usuarios reales de Chrome, medidos en el percentil 75 de los últimos 28 días. Los umbrales siguen siendo los mismos, LCP por debajo de 2,5 segundos, INP por debajo de 200 ms (sustituyó a FID en marzo de 2024) y CLS por debajo de 0,1.
Tres cosas que veo mal leídas cada semana:
El informe agrupa URLs parecidas. Lo que ves es un grupo con una URL de ejemplo, no la nota de cada página. Si el grupo de fichas de producto suspende, el problema está en la plantilla.
“Validar corrección” tarda 28 días. Si arreglas algo hoy y el lunes sigue en rojo, no está roto, es la ventana de CrUX.
Las páginas con poco tráfico no aparecen, porque no hay datos suficientes. Que no salgan errores no significa que vayan bien.
Si quieres más detalle, CrUX Vis te da el histórico, y desde hace unas semanas también las métricas de anuncios que contamos en la NDS #93.
Indexación, donde están los problemas de verdad
El informe de indexación de páginas es el que más información esconde, y casi siempre se mira solo el número de arriba. Lo que yo reviso:
“Descubierta” frente a “Rastreada: actualmente sin indexar”. Parecen lo mismo y piden soluciones opuestas. La primera suele ser un problema de rastreo, la segunda de calidad. Nacho Mascort lo explica muy bien en su artículo sobre quality, con los tiempos que enseñó Google en Barcelona, una indexación puede ir de hora y media a “meses o nunca” si la calidad no acompaña.
Filtrar por sitemap. Si divides tus sitemaps por tipo de página (categorías, fichas, blog), puedes filtrar el informe por cada uno y ver qué porcentaje se indexa de cada tipo. Es la forma más barata de encontrar la plantilla que falla. Si quieres repasar cómo montarlos, está el curso de sitemaps de la NDS #70.
Inspección de URL, la canónica de Google. Compara la “canónica declarada por el usuario” con la “canónica seleccionada por Google”. Cuando no coinciden, Google te está diciendo que no se cree tu etiqueta, y suele haber duplicados detrás.
Y el cajón más olvidado de todos, Ajustes → Estadísticas de rastreo. Ahí ves cuántas peticiones hace Googlebot al día, desglosadas por código de respuesta, tipo de archivo, tipo de Googlebot y si son descubrimiento o actualización. También el estado del host (DNS, conexión con el servidor y lectura del robots.txt). No sustituye a los logs, que vimos a fondo en el curso de la NDS #58, pero si un día ves un pico de 5xx o que Googlebot se pasa la semana rastreando JavaScript, aquí lo pillas antes que en el tráfico.
Mi checklist
Si abro una propiedad nueva, esto es lo que hago la primera semana:
Activar el filtro de marca y crear anotaciones con los cambios importantes del último año.
Separar los sitemaps por tipo de página.
Mirar las estadísticas de rastreo y el informe de indexación, por ese orden.
Configurar la exportación a BigQuery si la web pasa de unos miles de URLs.
Revisar cada semana el informe de IA generativa para ver qué páginas usa Google como fuente.
Y si te cansas de hacer los filtros a mano, la extensión VON SEO Tools que sacamos en la NDS #92 te los deja en un clic, marca y no marca, informacionales, long tail y consultas tipo IA.
Search Console tiene sus fallos, este fin de semana lo hemos visto. Pero con los rank trackers cada vez más ciegos, es el único sitio donde Google te cuenta lo que pasa con tu web sin intermediarios.
🏛️Historia SEO: el formulario de sitemaps que acabó siendo Search Console (2005)
Ganó la segunda opción. Ese experimento es la herramienta que tienes abierta en otra pestaña mientras lees esto.
Google quería que le ayudaras a rastrear
La idea era sencilla. Los rastreadores de 2005 no sabían qué páginas había en una web (sobre todo las dinámicas), cuándo cambiaban ni cada cuánto debían volver. En la entrevista que le hizo Search Engine Watch, Shivakumar lo resumió diciendo que los crawlers, simplemente, adivinaban.
Así que Google pidió ayuda a los webmasters. Subías un XML con tus URLs, la fecha del último cambio y cada cuánto se actualizaban, y Google lo tenía en cuenta. Venía con un generador de sitemaps de código abierto y con el protocolo publicado bajo licencia Creative Commons, para que otros buscadores pudieran usarlo también. Eso sí, sin garantías de indexar nada y sin efecto en el ranking.
De Sitemaps a Webmaster Tools (2006)
Catorce meses después, el producto ya se le había quedado pequeño al nombre. El 4 de agosto de 2006, Vanessa Fox escribía que estaban “rodeados de cajas de mudanza” y anunciaba el cambio, Google Sitemaps pasaba a llamarse Google Webmaster Tools, dentro de un nuevo portal llamado Webmaster Central.
Con el nombre llegaron funciones que algunos todavía recordamos con cariño, como un informe de errores de rastreo, la opción de regular la velocidad de Googlebot o el famoso ajuste para elegir si tu dominio preferido era con o sin www. Matt Cutts le explicó a eWeek que la idea era dar algo más de transparencia para que la gente no viera “solo una caja negra”.
Y en noviembre de ese mismo año pasó algo que te va a sonar. Google, Yahoo y Microsoft anunciaron que los tres soportarían el mismo protocolo de sitemaps, que se mudó a sitemaps.org con la versión 0.9. Era la primera vez que los tres se ponían de acuerdo en un estándar para webmasters, cinco años antes de schema.org, la historia que te conté en la NDS #93.
Y en 2015, Search Console
El 20 de mayo de 2015 llegó el último cambio de nombre. Google había investigado quién usaba la herramienta y descubrió que el “webmaster” clásico era solo una parte, también estaban los aficionados, los dueños de pequeños negocios, los SEOs, los diseñadores, los desarrolladores de apps... Para que nadie se quedara fuera por el nombre, Webmaster Tools pasó a ser Google Search Console. Ese mismo mes, el antiguo informe de consultas se convertía en Search Analytics, el abuelo del informe de rendimiento que usamos hoy.
Lo que se quedó por el camino
En estos 21 años han desaparecido muchas cosas que en su día parecían intocables:
El dominio preferido con o sin www, que se despidió en 2019, el mismo año en que Google apagó la versión antigua de Search Console tras lanzar la nueva en 2018.
La herramienta de parámetros de URL, retirada en 2022.
El ping de sitemaps, que Google dejó de aceptar en 2023.
El limitador de velocidad de rastreo, cuya retirada anunciaron a finales de 2023.
Y mientras tanto han llegado los Core Web Vitals, la inspección de URL, el filtro de marca y, este año, el informe de impresiones en AI Overviews y AI Mode que te contaba en el Destripando de esta semana.
Lo curioso es que, de todo lo que nació en 2005, lo que mejor ha aguantado es lo primero que se lanzó. El protocolo de sitemaps sigue en la versión 0.9 desde 2006, y sigue siendo de lo primero que configuras cuando das de alta una web. El experimento que podía fracasar estrepitosamente se quedó, al final, con la mejor parte.
📣 si te ha gustado la newsletter y quieres recompensar de algún modo las horas que me llevó preparar todo este contenido gratuito para ti, comparte este correo con alguien a quien pueda interesarse para suscribirse.
🤜🤛 Si quieres que escriba sobre un tema concreto, que analice alguna web en vivo, que pruebe alguna herramienta, patrocinar la newsletter o financiarme un viaje en moto por Europa ahora es el momento, ¡contáctame!
📚 Si te has perdido alguna publicación o quieres revisar las anteriores, tienes el archivo disponible online para tí.


¡Muchas gracias por la mención, Javier! Me alegra que el resumen te haya resultado útil y que hayas destacado esos puntos en tu newsletter. 😊