

Me hace mucha ilusión saludarte en esta edición de la newsletter NDS, espero que cumpla tus expectativas y si es así, o si no lo es, estaré encantado de que me des feedback.
¿Quién es Javier Flores y qué es NDS? :)
👨💻 ¡Hola ! Soy Javier Flores, consultor SEO en VisibilidadOn y creador de Notas de SEO (NDS), que estás leyendo ahora mismo. Esta newsletter nació en noviembre de 2024 como un espacio para compartir mis aprendizajes en SEO, marketing y negocios digitales. Si te gusta, dime qué opinas. Y si no... ¡también! 😉
🗂️ En el correo de hoy
1️⃣ La viñeta
2️⃣ Actualidad SEO
3️⃣ Curso Htaccess para SEO
4️⃣ Monitorizar tu presencia en ChatGPT
5️⃣ Recursos / herramientas
6️⃣ Destripando Google, Featured Snippets y datos estructurados
7️⃣ Historia SEO
👨🏻🏫 ¡MASTER VON SEO 2026!
¡Las plazas se acaban y empezamos en 7 días! (¡solo quedan 4 huecos!) ¿Quieres dar un cambio a tu carrera profesional como SEO este 2027? ¿Quieres asentar los conocimientos con una metodología probada con años y cientos de clientes?
La formación cada vez importa más, sí, pero sobre todo importa aprender con contexto, con casos reales y con gente que esté en la trinchera de verdad… y en la mejor agencia de SEO 2026 premiada por Marketing4ecommerce.
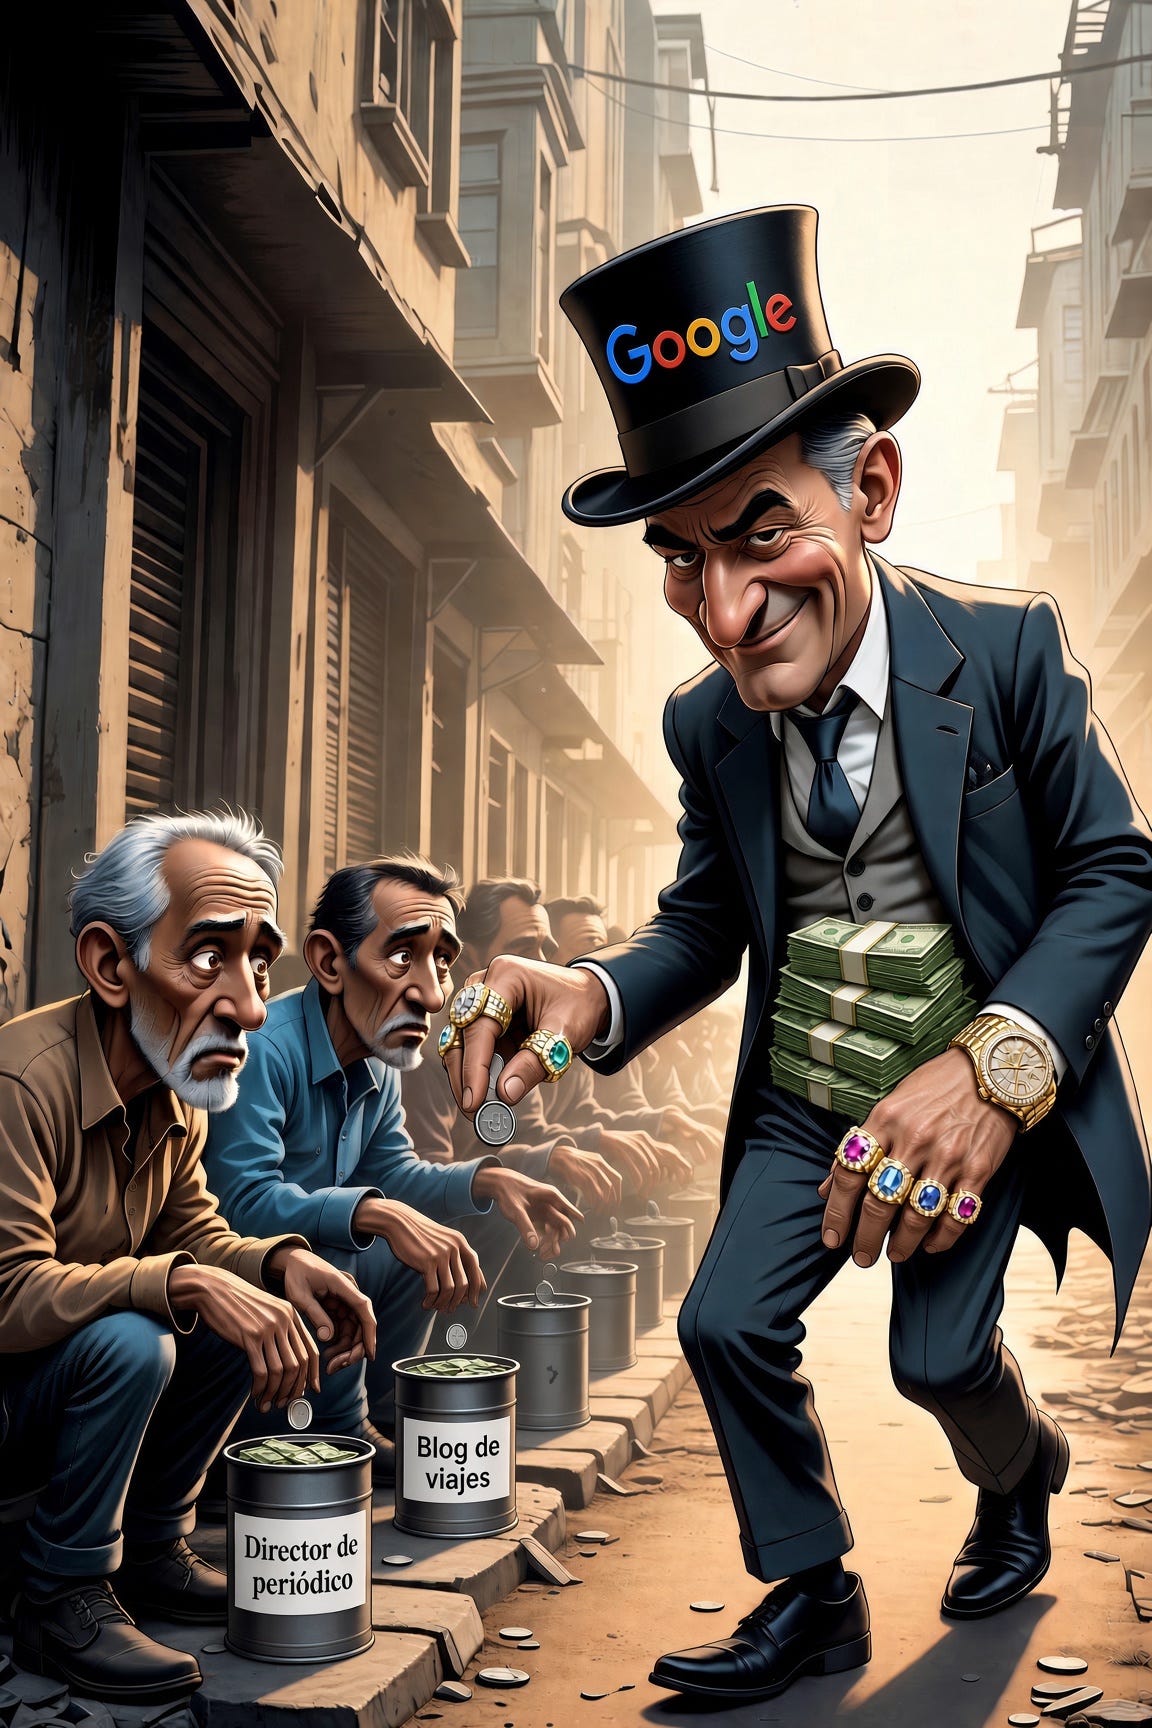
🖌️ La viñeta
📸 Actualidad SEO
Noticias que lees en un ratillo.
🖤 Prepara el Black Friday de tu eCommerce en 8 lecciones
El año pasado lanzamos una formación por email para preparar el Black Friday y os encantó. Este año Josep Deulofeu ha ido un paso más allá, ha grabado un curso de 8 lecciones con recursos prácticos y skills de IA, para que no te quedes en la teoría y lo puedas aplicar.
Y no lo ha preparado solo, se ha rodeado de gente que sabe mucho de eCommerce.
Josep Deulofeu se encarga de cuatro lecciones, la puesta a punto de la tienda, el antes, durante y después de un Black Friday rentable, el SEO/GEO y el calendario de comunicación.
Pere Pla da la de Google Ads.
Adrián Pedro Pérez, de Lejan Brand, habla de email marketing y recurrencia.
Dani Santos explica cómo preparar la web para convertir.
Carles Fos cierra con Meta Ads.
La idea es que termines con un plan claro para SEO, Ads, email y UX, en lugar de improvisar la semana antes. Si tienes una tienda online, o clientes que la tienen, este es el momento: el Q4 se prepara ahora.
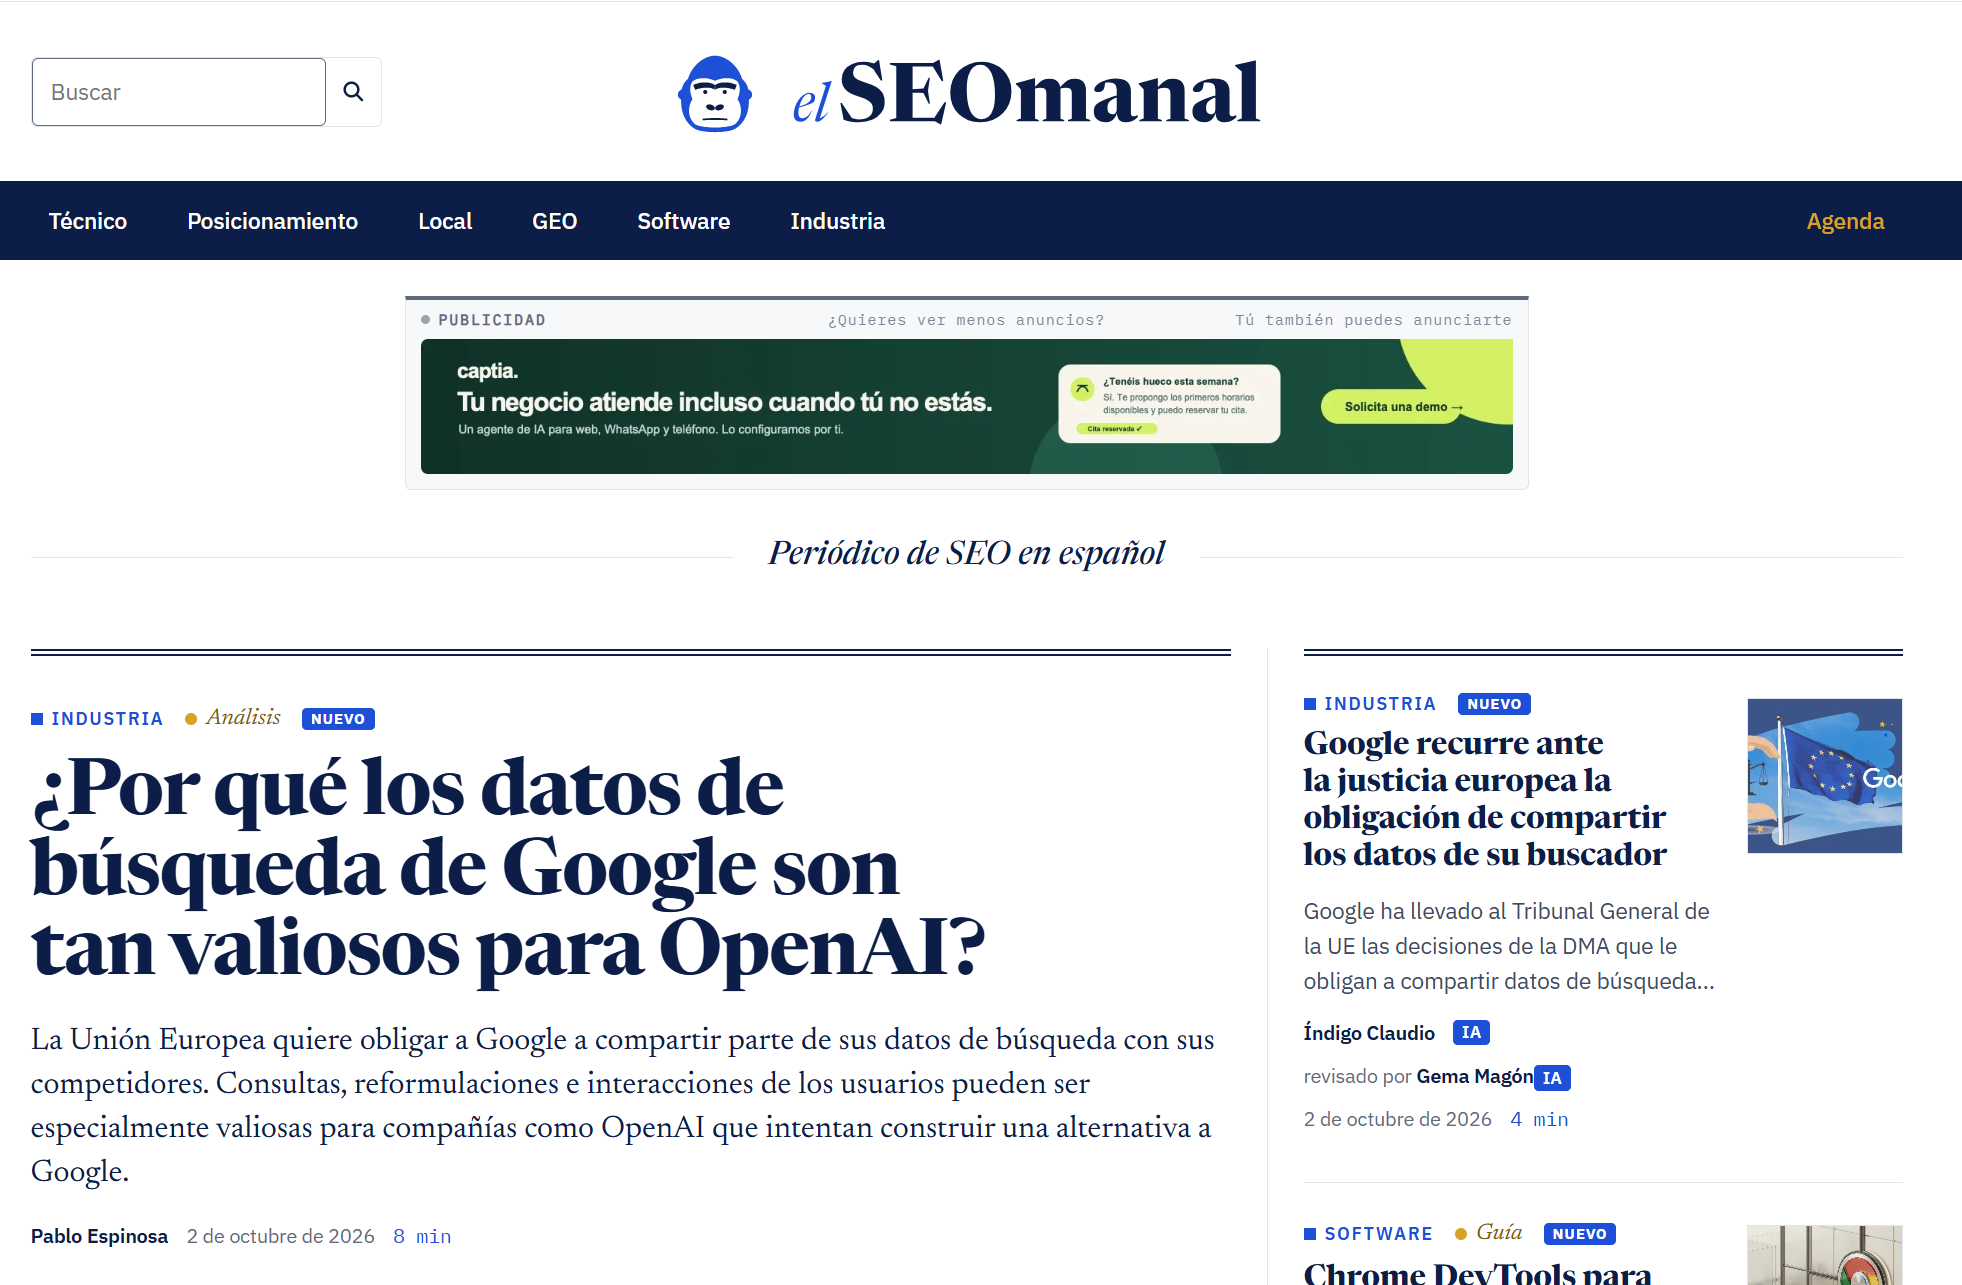
[🗞️ Nace el periódico SEO El SEOmanal] Carlos Sánchez ha lanzado esta semana el periódico SEO SEOmanal, un proyecto que trata de agrupar las noticias SEO más relevantes.
[🛒 Anthropic publica su receta para montar agentes de compra con Claude] Es un blueprint en abierto (código en GitHub) con dos agentes listos para usar:
Shopping: busca, compara, gestiona el carrito y tramita devoluciones.
Merchant: ventas, alertas de stock y propuestas de precios y promos, siempre con aprobación humana.
Prometen carritos +35% y +60% de compras completadas, aunque sin decir de dónde salen esas cifras. Detrás están Shopify, Wix, Klaviyo, Visa y Mastercard. Más contexto en la NDS #86.
[📈 CrUX ya mide cuánta publicidad metes en tu web] Google añade a CrUX cuatro métricas experimentales sobre anuncios:
Ad Count: media de anuncios visibles en pantalla.
Ad Density: qué porcentaje del viewport ocupan.
Ad Weight: lo que pesan en red (bytes) y en CPU (milisegundos).
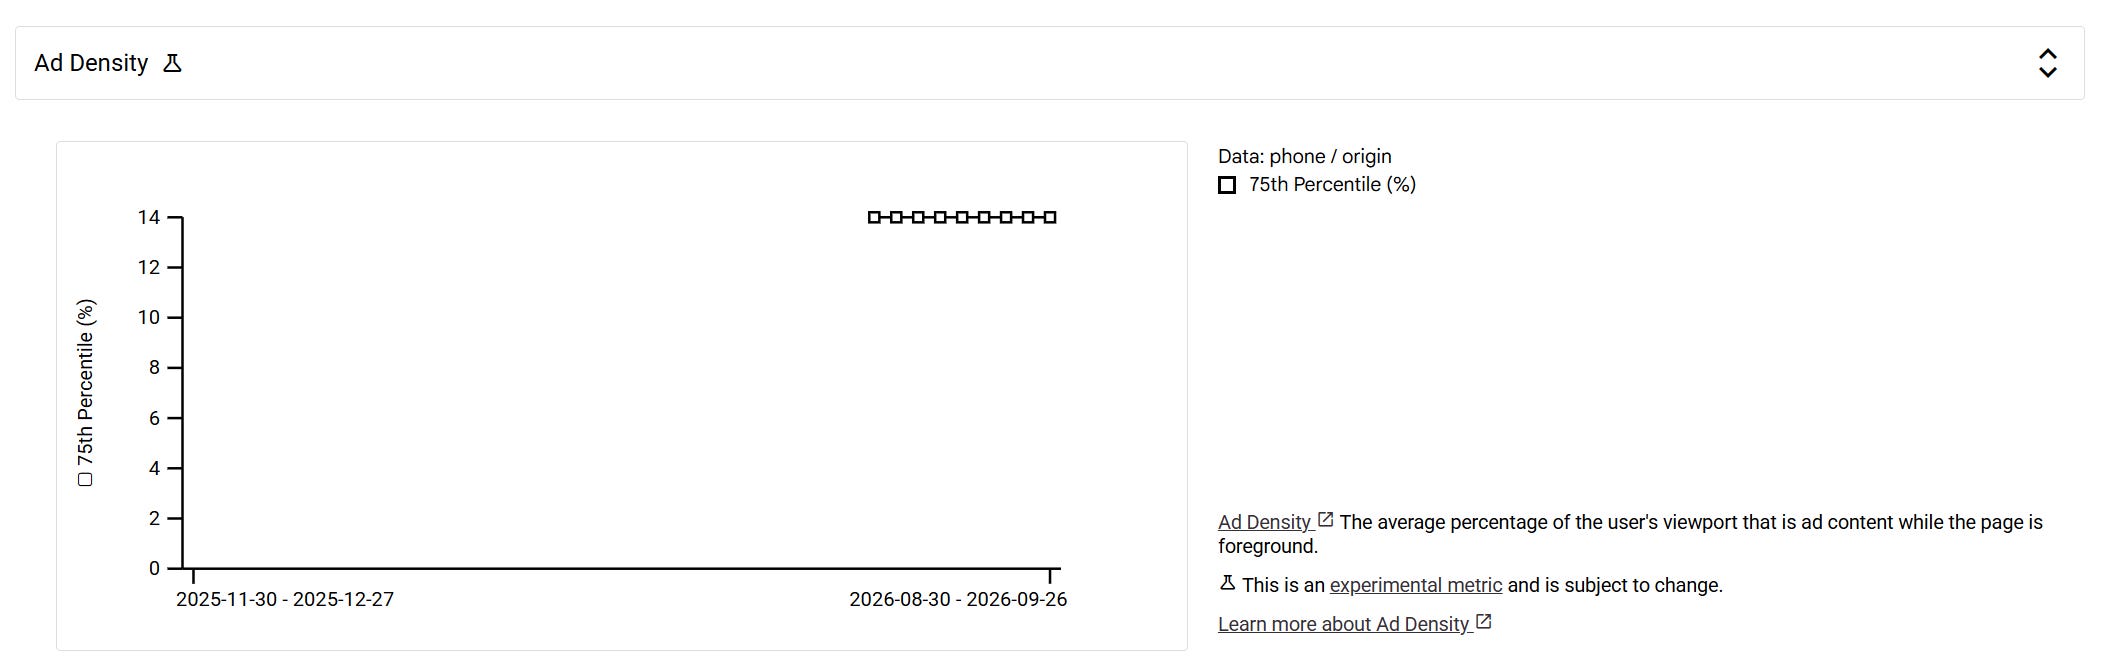
Se pueden consultar en la CrUX API, la History API y CrUX Vis. Google no dice que vayan a influir en el ranking, pero Glenn Gabe lo tiene claro, si tu web vive de la publicidad, “revísalo HOY”. ¡Medios del mundo escuchad! xD
[📊 LLM Pulse abre en abierto sus estudios de citas en IA] La herramienta de Esteve Castells publica una sección de data studies gratuitos. Ahí puedes ver qué dominios citan ChatGPT, Perplexity, Gemini, AI Mode y los AI Overviews, con datos que se actualizan cada noche (media de los últimos 7 días). Tienes rankings de medios, de UGC, de tiendas que aparecen en ChatGPT Shopping, la cobertura de los anuncios en ChatGPT y métricas de fan-out. Lo que más nos interesa aquí, hay un ranking específico de medios españoles, perfecto para enseñárselo a un cliente que pregunta dónde le conviene salir.
[🔎 Cómo busca ChatGPT cuando le preguntas por tu marca] MJ Cachón ha destripado 1.797 sub-queries de GPT 5.5 lanzadas a partir de prompts de marca. Lo más curioso es que busca como un SEO, un 30% de las veces tira de site: (sobre todo contra tu propio dominio), un 24% usa comillas para verificar frases literales y un 20% añade el año. Tip: cada dato corporativo debería tener su propia URL indexable y estar en HTML, no enterrado en un PDF.
[🦅 SOAR: las 4 claves para que te citen los LLMs] Growwer resume en un acrónimo las conclusiones del informe de Notified/PRWeek, que ha analizado 250.000 notas de prensa y unos 250 millones de citas en IA.
SOAR viene de Structure, Originality, Authority y Recency. Dicho de otra forma, contenido bien estructurado, datos propios que no tenga nadie más, menciones en medios y actualización constante. Nada que no sepamos, pero viene bien tenerlo en una sola palabra para explicárselo a un cliente.
[🧩 Así se monta un agente de compra que funcione (según Anthropic)] Es la parte técnica del blueprint de agentes de compra. Lo más útil para nosotros es cómo tratan el catálogo, los agentes solo usan IDs de producto que da el servidor y filtran las reseñas y fichas de terceros antes de que la IA las lea, por si alguien ha metido instrucciones escondidas. Además, todo lo que suponga dinero lo tiene que aprobar una persona. Si tus datos de producto están desordenados, el agente no se los va a inventar, directamente no te va a mostrar.
[📝 Mueller probó a servir Markdown a las IAs y solo picaron las herramientas SEO] John Mueller lo ha probado en sus webs y lo cuenta en r/TechSEO, "los únicos crawlers que dicen aceptar markdown son herramientas SEO".
Ni rastro de OpenAI, Anthropic y compañía. Su consejo es que, antes de montar versiones .md, registres en los logs la cabecera Accept para ver si algún bot las pide de verdad. Es la misma película que con el llms.txt, que ya mandamos al palco en la NDS #59.
[🖼️ Dejan crea un optimizador de alt text que puntúa contra la propia imagen] Dan Petrovic usa el modelo de embeddings multimodales de Google para medir cuánto se parece semánticamente el texto alternativo a lo que realmente sale en la foto, y lo va reescribiendo hasta que encaja. En su ejemplo, unas pulseras de Fitbit, pasa de un 59% a un 83% de similitud en 10 vueltas. De momento no es una herramienta independiente, viene dentro de su app Auxy.
[🔭 ChatGPT ha creado su propio índice de búsqueda] Al final, ¿las plataformas LLMs se están convirtiendo en buscadores para competir contra buscadores…?
Tomek Rudzki (Peec AI) lo ha pillado por un despiste de OpenAI. Durante dos meses, las respuestas de ChatGPT incluían un campo result_source que decía de dónde venía cada resultado, Labrador (su índice propio), Bright, Oxylabs o SERP. Y no es un único índice, sino varios por verticales: web, PDFs, YouTube, noticias, shopping... Así que se acabó lo de "si posicionas en Bing, sales en ChatGPT".
[🎭 SerpAPI también está creando su propio índice de búsqueda] Nos lo cuenta Natzir Turrado, ya está en preview, con 3.200 millones de páginas indexadas, y devuelve los resultados en JSON o Markdown, listos para que los use un LLM sin pasar por Google ni por proxies. Llevaba en alpha desde febrero sin anunciarse, y han decidido sacarlo ahora, justo cuando están en pleno juicio su CEO lo usa como argumento en la contrademanda a Reddit, alegando que el acuerdo exclusivo entre Reddit y Google les impide competir.
Eso sí, aunque 3.200 millones de páginas es un índice pequeño, más o menos como Common Crawl sirve para darle contexto a un LLM, pero para seguir posiciones vas a seguir necesitando scrapear Google.
[🧰 Microaudit.page] Carlos Ortega ha creado esta herramienta donde metes una URL y te revisa hasta 90 puntos de rastreo e indexación, etiquetas, datos estructurados, Core Web Vitals, E-E-A-T, internacional y hasta AI SEO. Es gratis, aunque si conectas tu API de Anthropic hace algunas comprobaciones más finas por unos 2 céntimos por análisis. Te dice qué corregir, lo puedes descargar en PDF y compara la puntuación con tus tests anteriores. Muy útil para hacer una primera revisión rápida antes de lanzar Screaming Frog, o para enseñarle a un cliente por dónde empezar.
[🗞️ Un medio puede ser cada vez más descubrible y cada vez menos rentable] Señor Muñoz (que ha lanzado su newsletter de SEO) responde a Harry Clarkson-Bennett, que defiende que los medios tienen que distribuir su contenido allí donde esté su audiencia. Está de acuerdo, pero plantea una pregunta incómoda, si te leen en TikTok, en un AI Overview o en ChatGPT, ¿quién cobra? Seguramente, tú no. Su propuesta es asignar a cada canal un valor económico, TikTok te da notoriedad, Google intención, la newsletter recurrencia, y la suscripción ingresos directos. Me quedo con esta frase suya: "Distribuir contenido sin pensar en cómo se captura su valor es confundir circulación con negocio".
👨🎓 Curso Htaccess para SEO
Masterizar el archivo .htaccess y el servidor Apache para optimizar el rendimiento, la seguridad y el SEO técnico de tus proyectos web.
Aprende a gestionar redirecciones sin perder fuerza de enlace, aplicar compresión y caché avanzada, y proteger tu sitio frente a bots y accesos no autorizados.
¿Qué aprenderás?
Fundamentos de Apache: Estructura, sintaxis, jerarquía de directorios y control de acceso seguro mediante IP.
Redirecciones y URLs Amigables: Dominio del motor
mod_rewrite, expresiones regulares (Regex), redirecciones 301/302 y unificación de protocolo (HTTPS y WWW).Optimización WPO: Configuración de caché de navegador (
mod_expires) y compresión de archivos (mod_deflate/Gzip) para mejorar las métricas de Core Web Vitals.Seguridad y Crawl Budget: Bloqueo de scrapers, protección contra hotlinking de imágenes y blindaje de archivos sensibles como
wp-config.php.Auditoría y Resolución de Errores: Diagnóstico de fallos 500 (Internal Server Error), gestión correcta de páginas 404 y verificación de reglas antes de su despliegue.
¿Para quién es este curso?
Consultores SEO y Especialistas Técnicos: Profesional de la optimización web que busca solucionar problemas de contenido duplicado, migración de dominios y preservación de autoridad.
Desarrolladores Web y Webmasters: Programadores que gestionan servidores Apache y requieren un control total sobre el comportamiento de sus sitios web a nivel de servidor.
Administradores de Sitios WordPress: Usuarios que desean personalizar y asegurar la directiva del servidor sin depender exclusivamente de plugins de terceros.
📺 Monitoriza tu presencia en ChatGPT
🧰Herramientas / recursos

Openseo es una plataforma de código abierto para keyword research, backlinks, seguimiento de posiciones y auditorías, con ya 20.000 estrellas en GitHub. Tiene dos detalles interesantes:
Pagas por consulta, no una cuota mensual de más de 100 €. Si te lo instalas en tu servidor, el software es gratis.
Es agent-native: tiene MCP para conectarlo a Claude, Codex o Gemini, se integra con Search Console y trae comandos como
/keyword-researcho/seo-audit.
Por detrás, los datos salen de DataForSEO, así que si ya tienes esa API conectada a tu IA, no te va a enseñar nada nuevo. Para quien empieza y no quiere pagar una suscripción, es una buena puerta de entrada.
🔍 Destripando Google, Featured Snippets y datos estructurados
Hace unos años, conseguir la “posición cero” era el trofeo que enseñabas al cliente en la reunión mensual. Hoy no tiene tanto brillo, pero sigue ahí, y los datos estructurados han pasado por una buena poda. Vamos por partes.
Featured Snippets, el abuelo de los AI Overviews
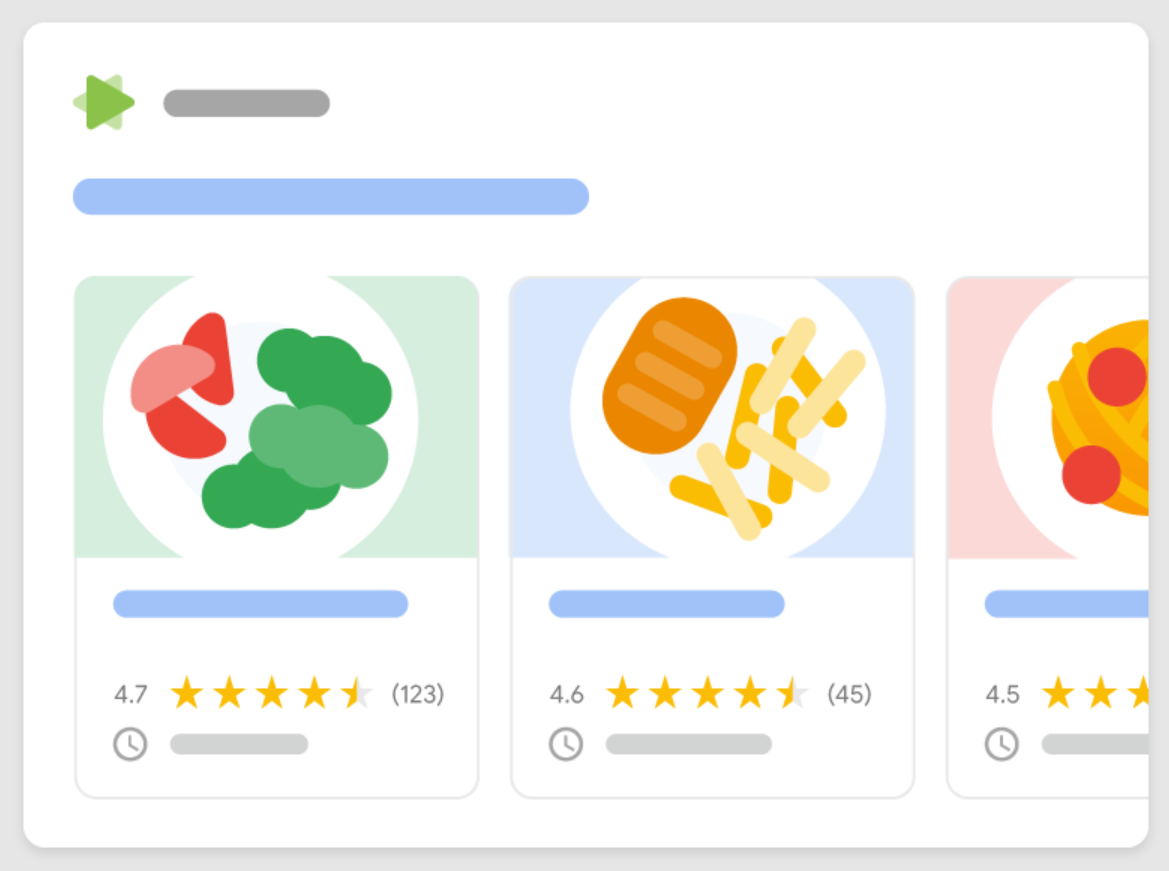
Google los lanzó en 2014, una respuesta sacada de tu web y colocada encima del primer resultado. En enero de 2020 cambió una regla importante, la deduplicación. Si consigues el snippet, esa URL ya no aparece en los resultados orgánicos de la primera página. Es decir, el snippet pasa a ser tu único resultado.
¿Cómo están ahora? Search Engine Land ha medido 1.508 búsquedas y los featured snippets salen en el 32,5%, mientras que los AI Overviews aparecen en el 84%. El CTR del snippet ronda el 17,7%, cuando antes llegaba al 35%. Aun así, tiene una ventaja que el AIO no tiene, todos los clics van a una sola URL, la tuya, y no se reparten entre cinco fuentes. Y un dato curioso, cuando los dos aparecen a la vez, se contradicen en un 32% de los casos.
Mi opinión es que siguen mereciendo la pena en búsquedas informacionales donde todavía salen, y lo que haces para ganarlos te sirve igual para que te cite la IA:
Pon la pregunta en un H2 y responde justo debajo, en 40-60 palabras.
Usa listas o tablas reales en HTML cuando la respuesta sea un paso a paso o una comparativa. Si las pintas con divs, Google no las lee igual.
Si el snippet te quita clics, porque la respuesta lo resuelve todo, puedes controlarlo con
max-snippetodata-nosnippet. Prueba antes de aplicarlo a todo el sitio.
Datos estructurados, lo que Google se ha cargado
La galería oficial de Google se ha quedado en 25 tipos, y en los últimos años han caído unos cuantos:
HowTo (2023) y cuadro de búsqueda de sitelinks (noviembre de 2024).
Siete tipos de golpe en junio de 2025: Book Actions, Course Info, ClaimReview, Estimated Salary, Learning Video, Special Announcement y Vehicle Listing.
Practice Problems, en enero de 2026.
FAQ, desde el 7 de mayo de 2026 (lo contamos en la NDS #75). El marcado sigue siendo válido, pero ya no da rich result.
En todos los casos, Google insiste en que quitarlos no afecta al ranking. Simplemente, ya no se ven en la SERP.
Lo que sí sigue mereciendo la pena
Si trabajas eCommerce, esto es lo primero que revisaría:
Product, que cubre tanto las fichas de comerciante como los snippets de producto, con precio, stock y valoraciones. Es lo que más se nota en la SERP y lo que alimenta Shopping.
Organization, sobre todo desde que Google permite declarar a nivel de empresa las políticas de envío y devolución (lo amplió en noviembre de 2025), sin tener que repetirlas en cada producto. Ojo con
returnPolicyCountry, que ahora es obligatorio.Breadcrumb, que es fácil, no falla nunca y limpia mucho la URL que se ve en la SERP.
Review snippet, siempre que las reseñas sean de producto. Las reseñas de tu propio negocio marcadas en tu web (self-serving) no muestran estrellas desde 2019.
Según el tipo de proyecto, también te pueden interesar Article, Video, LocalBusiness, Recipe, Event, JobPosting, ProfilePage y Discussion forum. Y luego hay tipos que existen, pero que en España casi nunca vas a usar, Speakable (beta y solo para noticias en inglés), Vacation rental (necesitas un acuerdo con Google), Dataset (solo funciona en Dataset Search) o Math solver.
¿Y para la IA?
Aquí hay mucho humo. Google dice en su guía de optimización para IA que no hace falta ningún marcado especial para salir en AI Overviews ni en AI Mode, y que optimizar solo los datos estructurados no tiene sentido. El schema ayuda a que Google entienda tu entidad y tus productos, y eso sí suma. Pero no hay pruebas sólidas de que un FAQPage te vaya a meter en ChatGPT.
Mi checklist sería esta: Product + Organization + Breadcrumb bien hechos y validados en Search Console, el contenido estructurado para responder rápido, y dejar de perder horas metiendo marcados que Google ya no muestra.
Fuentes:
🏛️Historia SEO: el día que Google, Bing y Yahoo se pusieron de acuerdo (2011)
2 de junio de 2011. Tres empresas que se pasaban el día intentando quitarse cuota de mercado publican a la vez el mismo anuncio. Google, Bing y Yahoo lanzan juntos schema.org, un vocabulario común para que las webs les explicaran qué había en cada página. Algo así como si Coca-Cola y Pepsi se pusieran de acuerdo en el tamaño de la lata.
El caos de antes
Google había lanzado los rich snippets en 2009, con estrellas, precios y autores en la SERP. El problema es que, para conseguirlos, cada buscador te pedía una cosa distinta. Estaban los microformatos (hCard, hReview...), RDFa, que venía del mundo de la web semántica del W3C, y Microdata, la novedad de HTML5. Google soportaba los tres y cada buscador recomendaba su propio vocabulario.
¿Qué hacían los webmasters? Lo lógico, nada. Los propios creadores de schema.org lo reconocieron años después en un artículo para ACM: “La mayoría de los webmasters simplemente no añadían ningún marcado, y el que añadían solía estar mal formateado”. Mientras tanto, los buscadores tenían que mantener extractores que se rompían cada vez que una web cambiaba de diseño.
El pacto
La solución fue ponerse de acuerdo en un único vocabulario y en un único formato. Schema.org salió con 297 tipos y 187 propiedades, y eligieron Microdata. Google lo explicó así en su anuncio oficial, “hemos decidido centrarnos en un único formato para contarle a los webmasters una historia más sencilla”. Bing dijo que querían “simplificar las opciones de marcado”, y Yahoo tranquilizó a todo el mundo prometiendo que lo que ya estuviera hecho en RDFa o microformatos iba a seguir funcionando.
En noviembre de ese mismo año se apuntó Yandex.
No a todo el mundo le gustó
A la comunidad de la web semántica le sentó fatal. Llevaban años trabajando en RDFa dentro del W3C, y de repente tres empresas privadas, sin consultar a nadie, decidían cuál era el estándar. Manu Sporny, que presidía el grupo de trabajo de RDFa, lo publicó con un título que lo dice todo, The False Choice of Schema.org. La presión funcionó, y schema.org acabó aceptando RDFa poco después.
Y aquí viene lo irónico. El formato que hoy usa casi todo el mundo no es ninguno de esos dos. Es JSON-LD, que Google empezó a soportar en 2015 y que desde 2017 recomienda “siempre que sea posible” (Wikipedia).
Lo que vino después
La adopción se disparó. En 2015, schema.org ya aparecía en el 31,3% de las páginas de una muestra de 10.000 millones, un año antes estaba en el 22%. Hoy pasa de los 800 tipos y lo usan más de 45 millones de dominios.
Lo curioso es lo que ha pasado con los rich results que justificaron todo esto. Como contamos en el Destripando de esta semana, Google ha ido eliminando muchos de ellos (HowTo, FAQ, ClaimReview...). El vocabulario, en cambio, sigue más vivo que nunca, porque se ha convertido en la forma de que los buscadores, y ahora las IAs, entiendan quién eres y qué vendes.
Al final, el gran legado de 2011 no fueron las estrellitas amarillas. Fue que tres competidores firmaran el mismo diccionario y que hoy, quince años después, todos lo sigamos usando.
Estamos en contacto
Puedes encontrarme en Linkedin, Twitter, mi blog, en mi canal de Youtube o trabajando a diario en la Agencia VisibilidadOn
🤜🤛 Si quieres que escriba sobre un tema concreto, que analice alguna web en vivo, que pruebe alguna herramienta, patrocinar la newsletter o financiarme un viaje en moto por Europa ahora es el momento, ¡contáctame!
📚 Si te has perdido alguna publicación o quieres revisar las anteriores, tienes el archivo disponible online para tí.